علیبابا از Qwen3.8-Omni-Flash و Realtime رونمایی کرد؛ مدل چندوجهی جدید برای اجرای مستقل
علیبابا از نسل تازه مدل چندوجهی خود با نام Qwen3.8-Omni-Flash رونمایی کرد؛ مدلی که هدف آن فراتر رفتن از درک متن، تصویر، صدا و ویدیو و رسیدن به برنامهریزی، فراخوانی ابزارها و اجرای مستقل کارها است. این مدل با پنجره زمینه یک میلیون توکن، در ۲۹ ارزیابی بهطور میانگین بیش از ۲۵ درصد بهتر از Qwen3.5-Omni-Plus عمل کرده و هزینه پردازش صوت و صوتوتصویر را نیز بهشدت کاهش داده است.
Qwen3.8-Omni-Flash یک مدل بومی چینی چندوجهی است که برای کار با محتوای متنی، تصویری، صوتی و ویدیویی توسعه یافته و پنجره زمینه یک میلیون توکنی دارد. این مدل ضمن حفظ عملکرد متنی نزدیک به مدل متنی هماندازه، روی قابلیتهای چندوجهی نیز پیشرفت کرده است. Qwen میگوید مدل جدید با تکیه بر داده بیشتر، زمینه طولانیتر و محیطهای عاملمحور، میتواند از درک محتوا به سمت برنامهریزی، استفاده از ابزار و تکمیل وظایف حرکت کند.
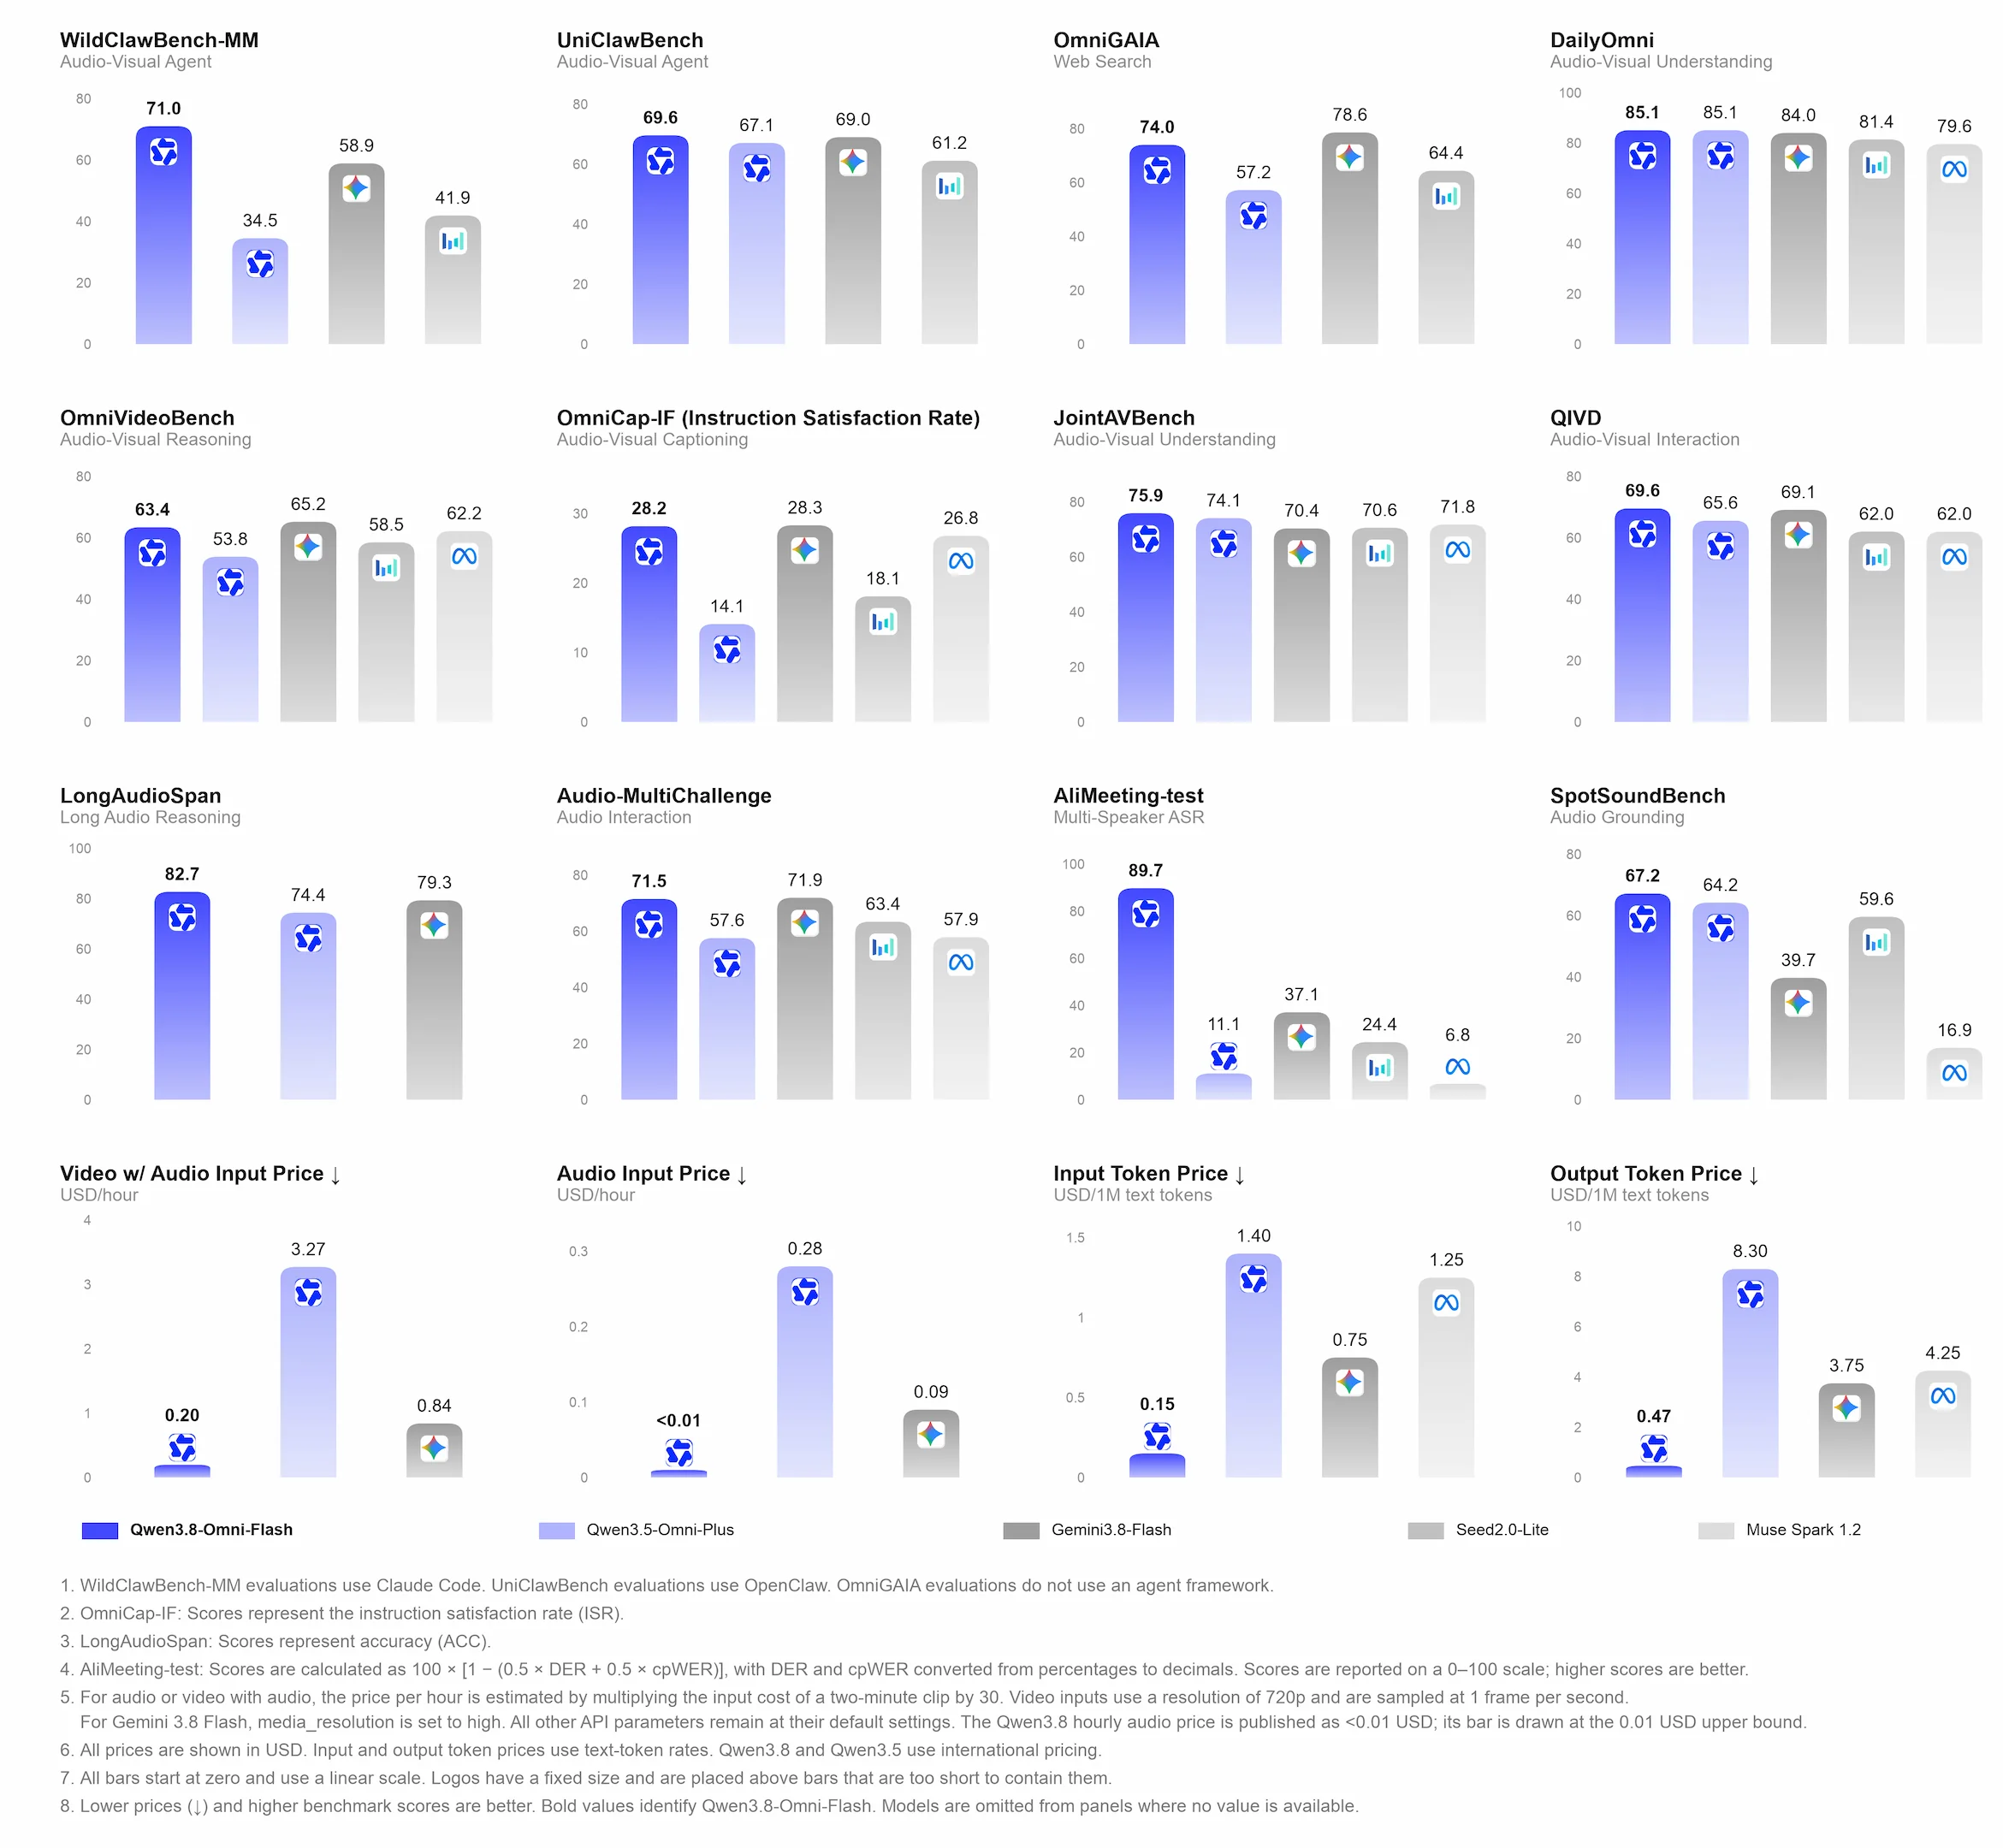
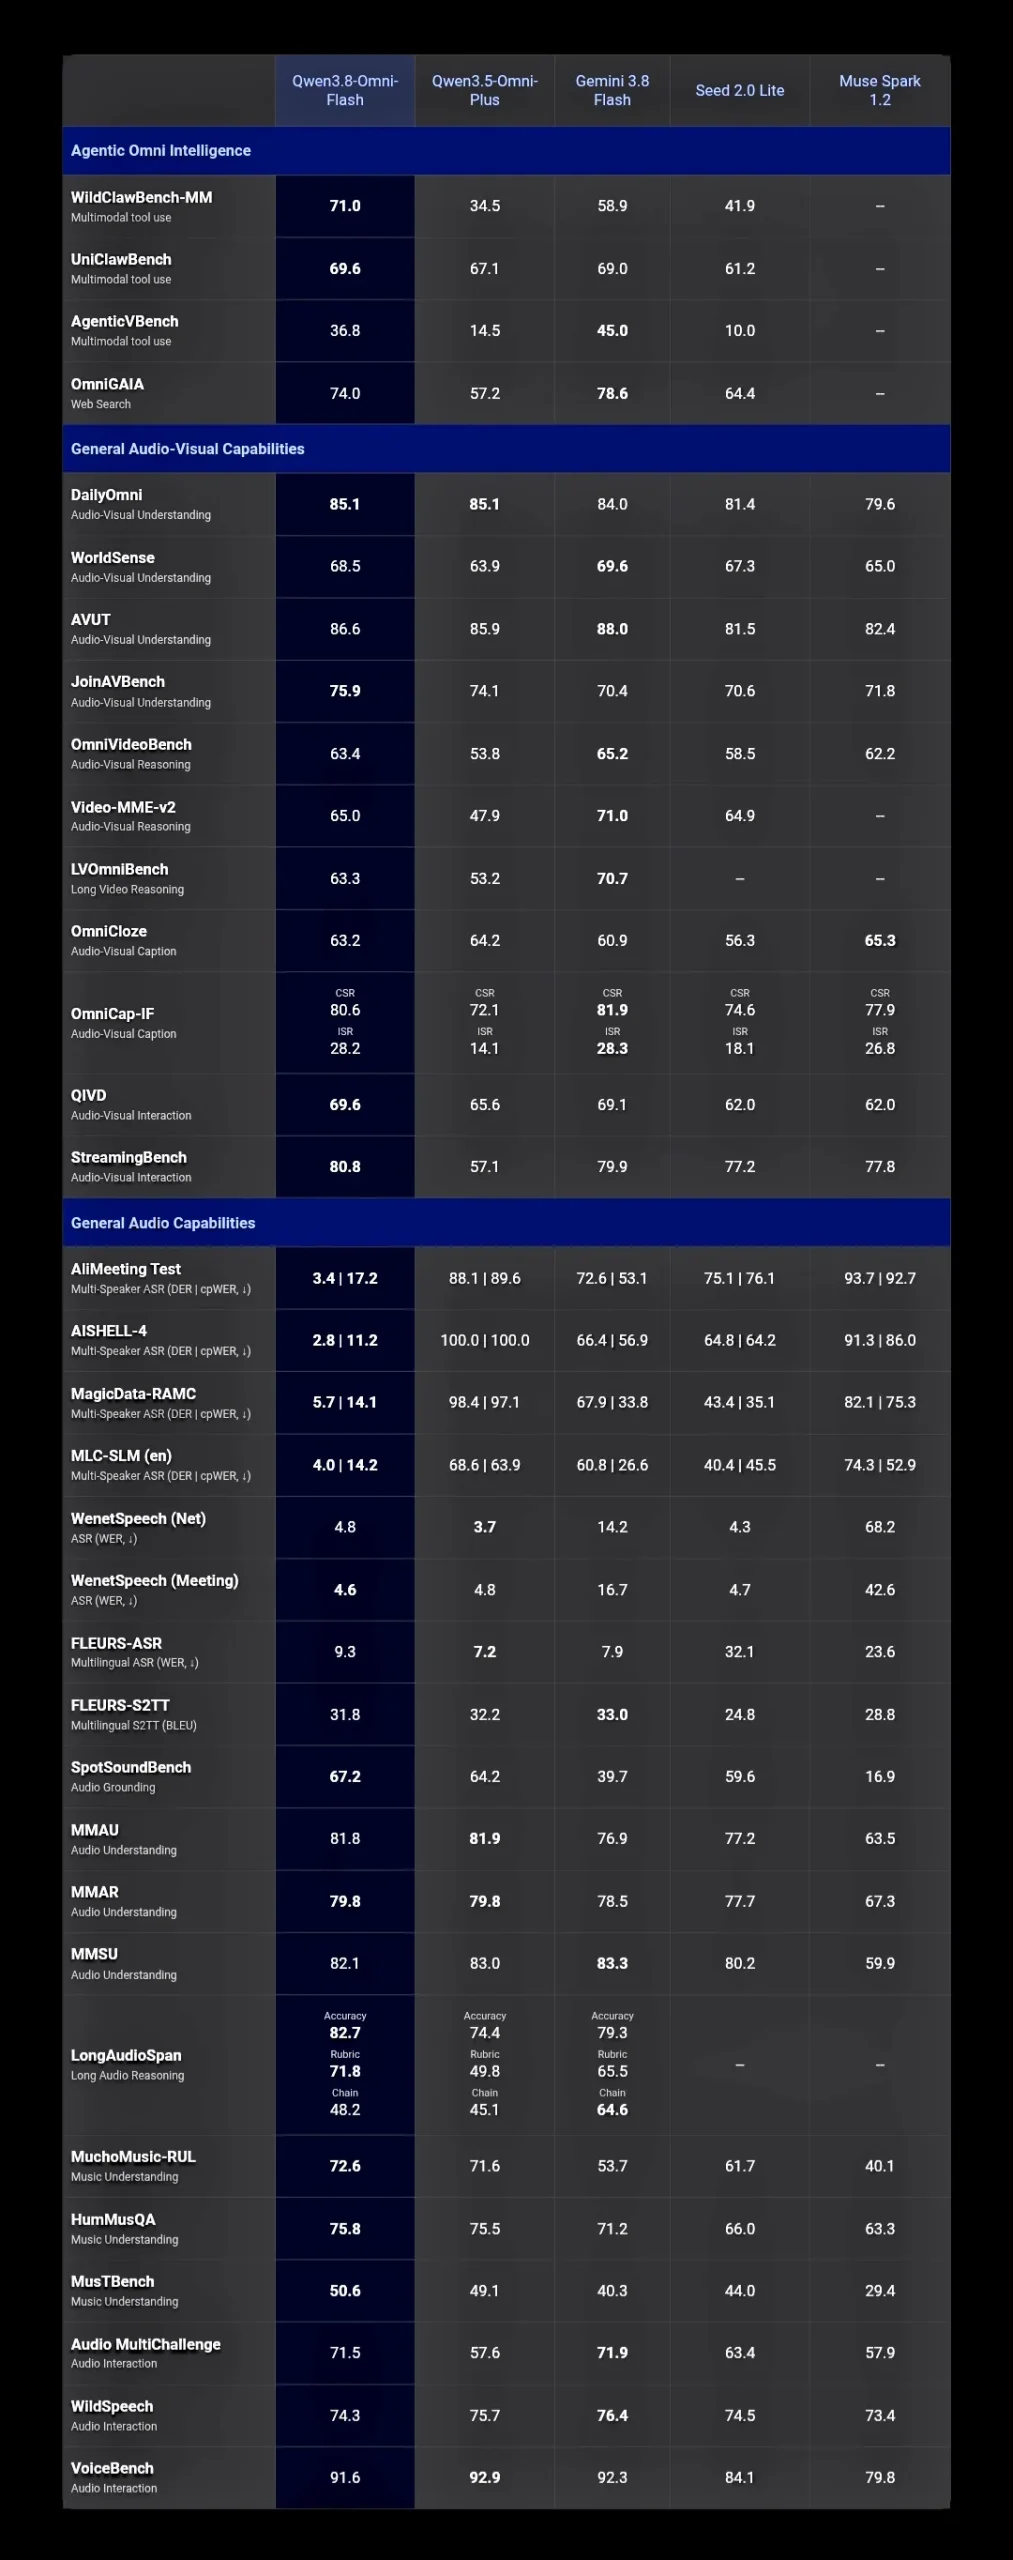
طبق اعلام Qwen، هزینه API برای هر ساعت ورودی صوتی بیش از ۹۸ درصد و برای هر ساعت ورودی صوتیتصویری بیش از ۹۳ درصد کاهش یافته است. Qwen3.8-Omni-Flash در WildClawBench-MM امتیاز خود را ۳۶.۵ واحد و در AgenticVBench به میزان ۲۲.۳ واحد افزایش داده و در UniClawBench نیز به امتیاز ۶۹.۶ رسیده است. عملکرد صوتیتصویری آن به Gemini 3.8 Flash نزدیک شده و عملکرد کلی صوتی از آن فراتر رفته است.
این مدل در درک صوت و ویدیوی طولانی، استدلال صوتیتصویری، کپشنگذاری و تشخیص چند گوینده نیز پیشرفت کرده است. امتیاز LongAudioSpan آن ۸.۳ واحد و OmniVideoBench آن ۹.۶ واحد بیشتر شده است. شاخصهای CSR و ISR در OmniCap-IF بهترتیب ۸.۵ و ۱۴.۱ درصد افزایش یافتهاند. همچنین نرخ خطای تشخیص گوینده در AliMeeting از ۸۸.۱۱ به ۳.۳۵ و cpWER از ۸۹.۶۱ به ۱۷.۱۸ کاهش پیدا کرده است.
این پیشرفتها بخشی از رویکردی هستند که در آن صوت و ویدیو دیگر صرفاً ورودی ادراکی مدل محسوب نمیشوند و به رسانههایی برای شناخت محیط، استدلال و اجرای وظیفه تبدیل میشوند. با این حال، استفاده عاملها از محتوای صوتی و ویدیویی طولانی چالشهای فنی خاصی دارد؛ زیرا ذخیرهسازی، انتقال و پردازش چندباره این دادهها پرهزینه است و چارچوبهای عاملمحور موجود نیز پشتیبانی بومی کاملی از این رسانهها ندارند.
Qwen برای حل این مشکلات، توسعه مدل، ابزارهای اجرایی و محیط زماناجرا را همزمان پیش برده است. Qwen3.8-Omni-Flash برای اتصال فهم منبع، برنامهریزی کار، اجرای ابزار و تحویل نتیجه در یک زنجیره واحد طراحی شده و میتواند گردشکارهای طولانی مانند ویرایش ویدیو، ترجمه، نقد فیلم و تولید محتوا را پوشش دهد. این رویکرد، قابلیتهای Omni را از درک صوت و تصویر به سمت اقدام و تکمیل مستقل وظایف گسترش میدهد.
بنچمارک و نمایش قابلیتهای Qwen3.8-Omni-Flash:
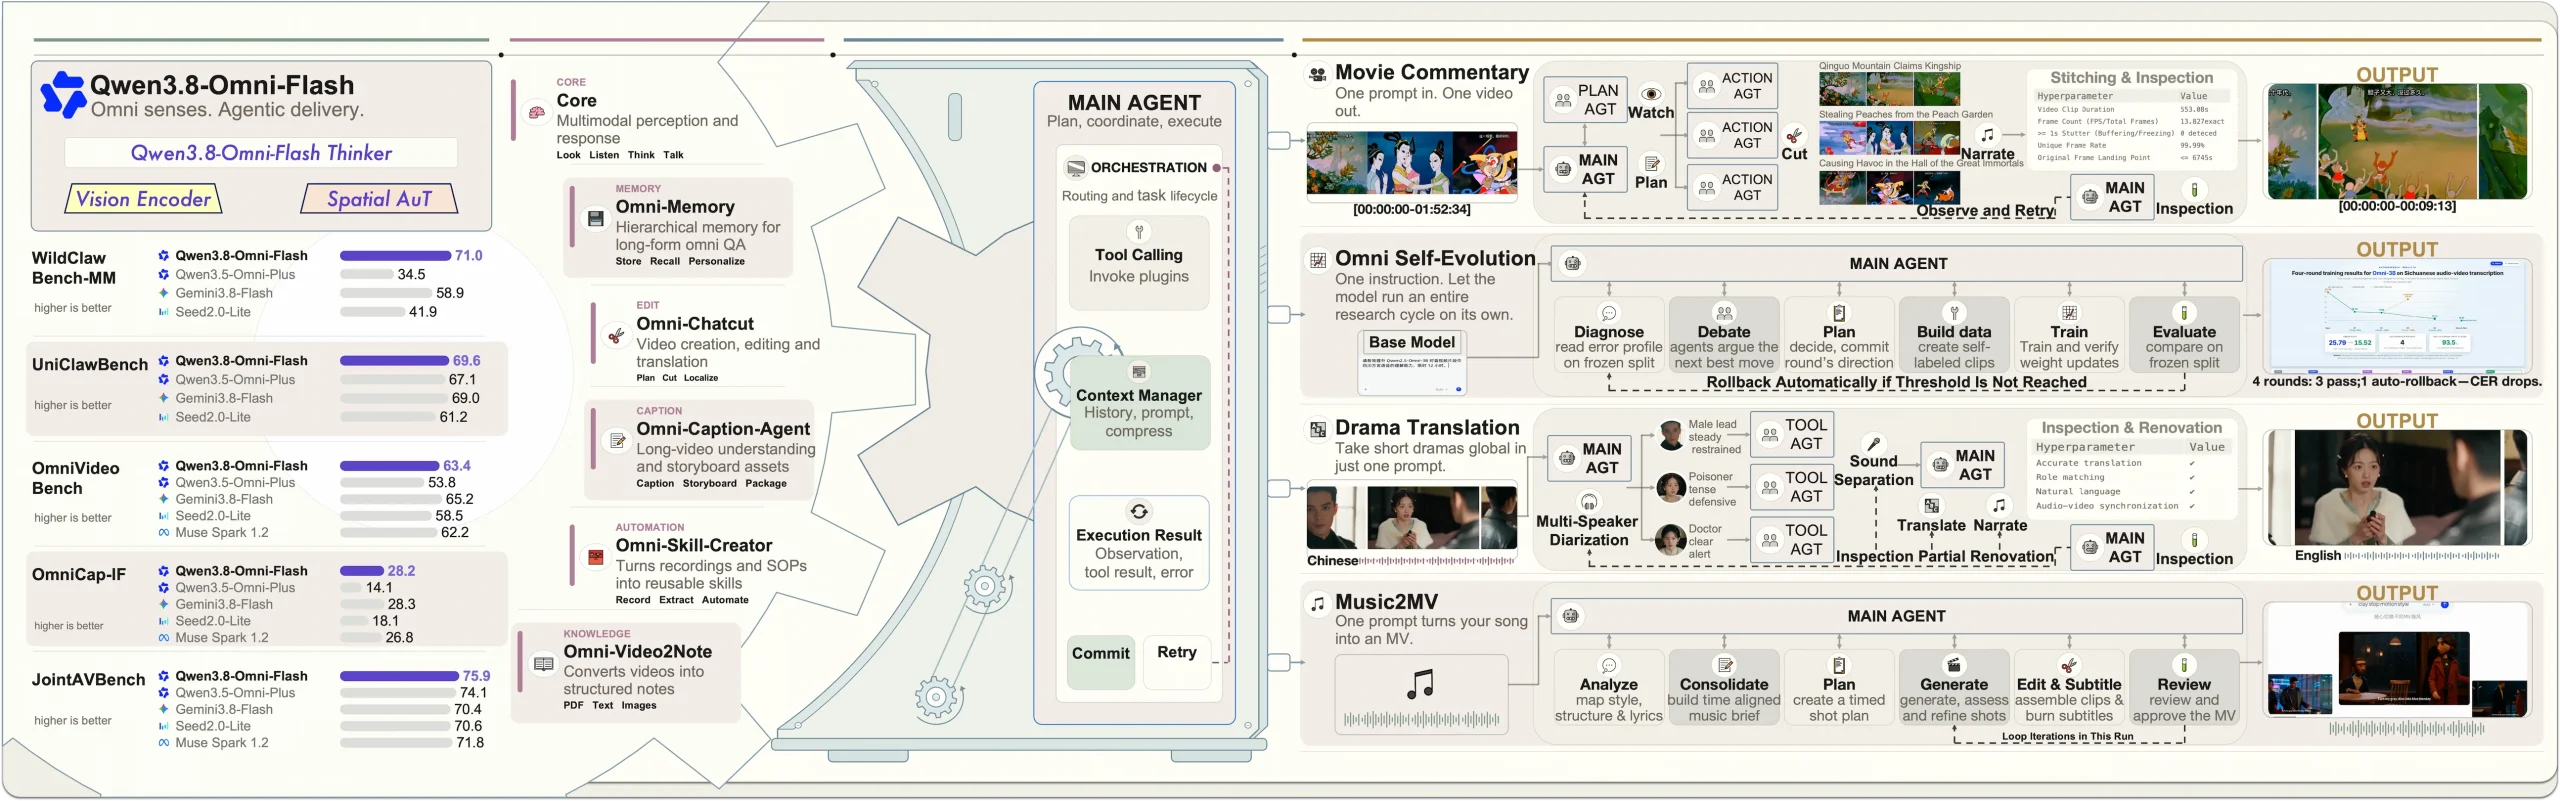
برای استفاده در محیطهای عاملمحور، Qwen مجموعه Qwen-MM-Plugins را توسعه داده است؛ این مجموعه قابلیت درک تصویر، صوت، ویدیو و اسناد، حافظه برای محتوای ویدیویی طولانی، تولید محتوا، ادراک درخواستی، استفاده از ابزار و اجرای گردشکار را در اختیار عاملها قرار میدهد. Qwen-MM-Plugins از چارچوبهایی مانند Codex، Claude Code، Qwen Code، Gemini CLI، Qoder، CodeBuddy و OpenClaw پشتیبانی میکند و از مشارکت توسعهدهندگان جامعه نیز استقبال میکند.
در سطح استفاده برنامهنویسی نیز Qwen3.8-Omni-Flash برای کاربردهای عاملمحور طراحی شده و قابلیتهایی مانند فراخوانی تابع، جستوجوی وب، خروجی ساختاریافته، ذخیرهسازی زمینه و پردازش دستهای را در اختیار برنامههای مبتنی بر API قرار میدهد. این مدل همچنین از پروتکلهای DashScope و OpenAI برای یکپارچهسازی پشتیبانی میکند و میتواند در جریانهای کاری مختلفی که به دریافت محتوای چندوجهی و اجرای اقدامات نیاز دارند مورد استفاده قرار گیرد.
در بخش صوتی، مدل از صدای فضایی نیز پشتیبانی میکند و میتواند ورودیهای صوتی دوکاناله و چهارکاناله را دریافت کند. این قابلیت در کنار درک تصویر و ویدیو، زمینه را برای کاربردهایی فراهم میکند که موقعیت مکانی صدا در آنها اهمیت دارد. Qwen3.8-Omni-Flash به همین دلیل فقط برای تحلیل محتوای از پیش ضبطشده طراحی نشده و بخشی از معماری آن به استفاده عاملها از اطلاعات صوتی و تصویری در محیطهای پیچیده اختصاص دارد.
یکی از کاربردهای مطرحشده، تحقیق پیرامون ویدیو است؛ جایی که پاسخ یک پرسش لزوماً داخل همان ویدیو قرار ندارد. Qwen3.8-Omni-Flash نیاز کاربر را با محتوای ویدیو ترکیب میکند، موضوعات نیازمند بررسی بیشتر را تشخیص میدهد و منابع چندوجهی وب شامل تصویر، ویدیو و سند را جستوجو میکند. خروجی، گزارشی پژوهشی و تصویری است که بر ویدیو تمرکز دارد و برای درک محتوا و حل مسئله عملی استفاده میشود.
در نمونهای مربوط به فتوشاپ، اگر کاربر هنگام جدا کردن مو از پسزمینه با هالههای رنگی در لبهها مواجه شود، عامل میتواند مراحل آموزش را بررسی کند، اصول حالتهای ترکیبی Multiply و Screen را توضیح دهد و روشهای جایگزین اصلاح لبه را مقایسه کند. سپس بر اساس شرایط کاربر مشخص میکند کدام رویکرد مناسبتر است؛ یعنی پاسخ فقط از محتوای ویدیو استخراج نمیشود و به تحقیق تکمیلی نیز متصل میشود.
Qwen3.8-Omni-Flash در تولید و ویرایش محتوای صوتیتصویری نیز بهعنوان عامل مطرح شده است. در ساخت موزیکویدیو، مدل میتواند ساختار آهنگ، ریتم، حالوهوا، آواز و تغییرات سازهای آن را با جزئیات بررسی کند تا طراحی شخصیت، صحنه و نما بر اساس موسیقی انجام شود. همچنین متن ترانه را در سطح خط و همراه با زمانبندی تولید میکند تا آواز، زیرنویس و تصاویر با یکدیگر هماهنگ شوند.
ترکیب Qwen-3.8-Omni-Flach با ابزارهایی مانند Qwen-MM-Plugins امکان ادامه این فرآیند تا بررسی نهایی کیفیت را فراهم میکند. در این گردشکار، فهم موسیقی، برنامهریزی خلاقانه، تولید و کنترل خروجی در یک زنجیره قرار میگیرند. Qwen این نمونه را برای نمایش تواناییهای مدل در درک، استدلال و تولید محتوای صوتیتصویری ارائه کرده است؛ بنابراین نقش مدل از تحلیل یک فایل صوتی به مدیریت بخشهای مختلف فرآیند ساخت موزیکویدیو گسترش مییابد.
فریمی از بنچمارکهای Qwen3.8-Omni-Flash و مقایسه با چند رقیب:
ترجمه و بومیسازی ویدیو نیز از دیگر سناریوهای هدف است؛ روشهای سنتی معمولاً به جابهجایی میان ابزارهای رونویسی، ترجمه، دوبله و تدوین نیاز دارند و هماهنگ نگه داشتن درخواستهای API، صدای شخصیتها، مدت دیالوگ و ریتم تصویر دشوار است. عامل مبتنی بر Qwen3.8-Omni-Flash میتواند با یک دستور، گویندگان را تشخیص دهد، گفتوگو را ترجمه کند، صدای شخصیتها را شبیهسازی و دوبله کند، صدا را بازترکیب کند و کیفیت نسخه نهایی را بررسی کند.
این روند، مراحل پراکنده بومیسازی را به یک گردشکار واحد تبدیل میکند و امکان تولید خودکار سریالهای کوتاه برای مخاطبان بینالمللی را فراهم میسازد. سناریوی دیگر، ساخت ویدیوهای نقد فیلم از آثار دو یا سهساعته است؛ کاری که معمولاً به تماشای چندباره فیلم، بازسازی خط داستانی، انتخاب نما، نوشتن متن، ضبط صدا، انتخاب موسیقی و تدوین نیاز دارد و به همین دلیل زمانبر و پیچیده است.
عامل مبتنی بر Qwen3.8-Omni-Flash میتواند پس از دریافت فیلم و توضیح درباره نیاز خلاقانه، درک طولانیمدت ویدیو، استخراج بخشهای کلیدی داستان، برنامهریزی نقد، تولید گویندگی و موسیقی، تدوین، رندر و بررسی نهایی را انجام دهد. این عامل همچنین میتواند دیالوگ اصلی را میان بخشهای نقد قرار دهد و سرعت و بلندی صدا را تنظیم کند تا روایت، صدای اصلی، موسیقی پسزمینه و تصویر هماهنگتر و طبیعیتر کنار هم قرار گیرند.
Qwen در بخش توسعه مدل نیز از همین قابلیت عاملمحور استفاده کرده است و از آنجا که کاربردهای چندوجهی واقعی باید کیفیت، تأخیر، توان پردازشی و هزینه استقرار را مدیریت کنند، استفاده از مدلهای کوچکتر و تخصصی برای مقیاسپذیری اهمیت دارد. با این حال، ساخت چنین مدلهایی معمولاً به تولید داده، تشخیص مشکل، چند مرحله آموزش و ارزیابی و دخالت متخصصان نیاز دارد. Qwen3.8-Omni-Flash برای کاهش این وابستگی وارد چرخه توسعه مدل شده است.
در یک آزمایش، Qwen3.8-Omni-Flash مأمور شد توانایی تشخیص گفتار گویش سیچوانی را در Qwen2.5-Omni-3B طی ۱۲ ساعت بهبود دهد و یک مدل قابل استفاده تحویل دهد. عامل بهصورت مستقل مجموعه ارزیابی WenetSpeech-Chuan را انتخاب کرد، معیار ارزیابی را تعیین کرد و خط پایه ساخت. سپس نمونههای صوتی را مستقیماً شنید، مشکلات را از روی نتایج تشخیص بررسی کرد و داده آموزشی هدفمند تولید کرد.
این فرآیند در چهار دور آزمایش ادامه پیدا کرد و عامل در مجموع ۳۴۱۳ نمونه آموزشی ساخت، با توجه به بازخورد ارزیابی روش خود را تغییر داد، بهبودهای مؤثر را نگه داشت و تلاشهای ناموفق را کنار گذاشت. در پایان، نرخ خطای کاراکتری Qwen2.5-Omni-3B روی همان مجموعه ارزیابی از ۲۵.۷۹ درصد به ۱۵.۳ درصد رسید که معادل کاهش نسبی حدود ۴۰.۷ درصد است. Qwen این آزمایش را نمونهای از تکامل مدل با کمک عاملها معرفی میکند.
این آزمایش همچنین الگویی را نشان میدهد که در آن مدل چندوجهی عمومی، داده را میفهمد، آزمایشها را برنامهریزی میکند و چرخه بهبود را پیش میبرد، در حالی که مدل کوچکتر قابلیت تخصصی مورد نیاز یک کاربرد مشخص را به دست میآورد. در چنین رویکردی، عاملها فقط از مدلها برای حل مسائل تجاری استفاده نمیکنند؛ بلکه میتوانند در فرایند ساخت و بهینهسازی مدل مورد استفاده برای همان مسئله نیز نقش داشته باشند.
Qwen بخش دیگری از پروژه را به تبدیل محتوای خطی و نامنظم صوت و ویدیو به اطلاعات قابل استفاده اختصاص داده است. این مدل با درک همزمان صدا، تصویر و خط زمانی میتواند اطلاعات را استخراج، ساختار آن را بازآرایی و نتیجه را بررسی کند. هدف، تبدیل دانش و تجربه عملی موجود در ویدیوهای طولانی به داراییهای اطلاعاتی متراکمتر است تا دسترسی، مرور و استفاده دوباره از آنها سادهتر شود.
برای این هدف، قابلیت متنباز Video2Note در Qwen-MM-Plugins ارائه شده است. این ابزار با استفاده از درک مشترک گفتار، تصویر و فرآیند، دانش را سازماندهی میکند، مراحل مهم را از هم جدا میکند، فریمهای نماینده را برمیگزیند و یادداشتهای PDF شامل متن و تصویر میسازد. بررسی خودکار و اصلاح تکرارشونده نیز برای فشرده کردن ساعتها ویدیو به اسنادی خوانا و قابل مراجعه دوباره در این فرایند قرار گرفته است.
Qwen همچنین Omni Skill Creator را بهعنوان قابلیت متنباز دیگری در Qwen-MM-Plugins معرفی کرده است. این ابزار میتواند دستورالعملهای عملیاتی استاندارد یا SOP را از نمایش یک کار استخراج کند تا برای اجرای خودکار و تکرارشونده استفاده شوند. همچنین امکان یادگیری شیوه استفاده از ابزار، معیارهای تصمیمگیری و نکات کلیدی از آموزش متخصص را دارد. نتیجه، تبدیل یک نمایش واحد به مهارتی عاملمحور، ارزیابیشده و قابل استفاده مجدد و اشتراکگذاری است.
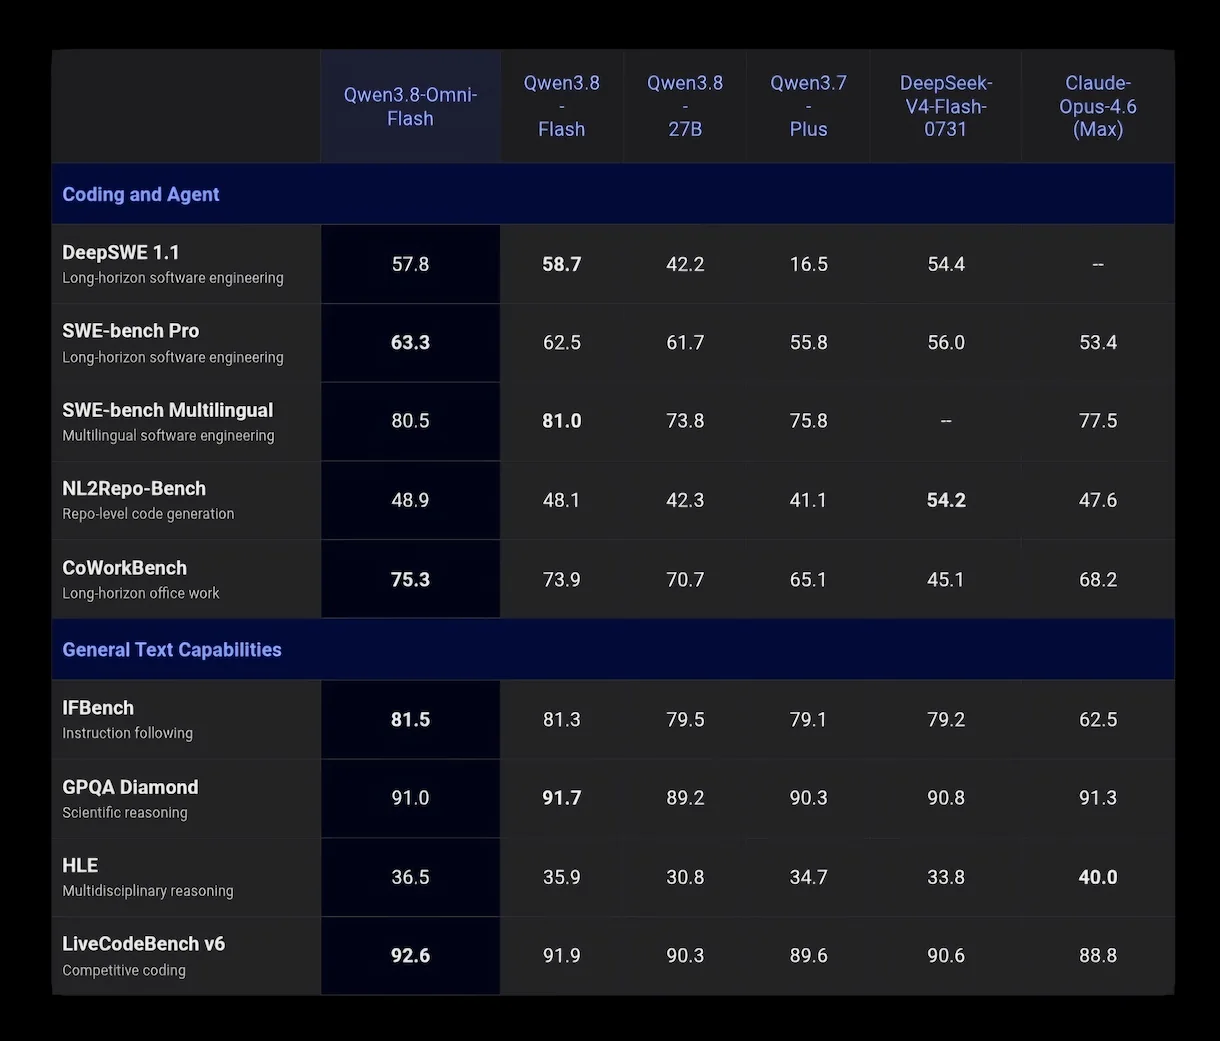
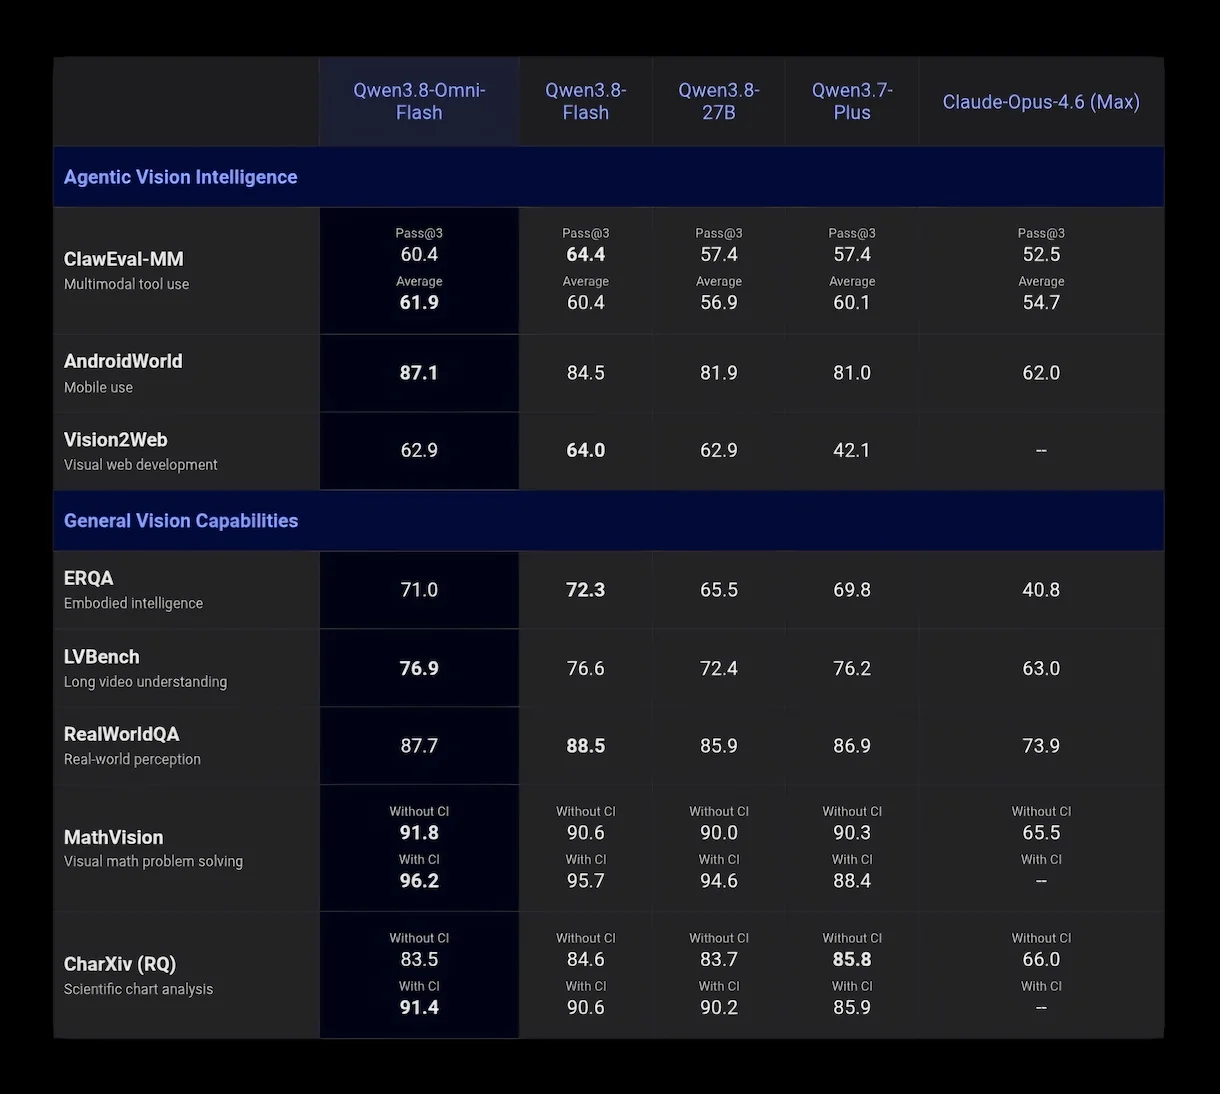
فریمهای دیگر از بنچمارکهای Qwen3.8-Omni-Flash و مقایسه با چند رقیب:
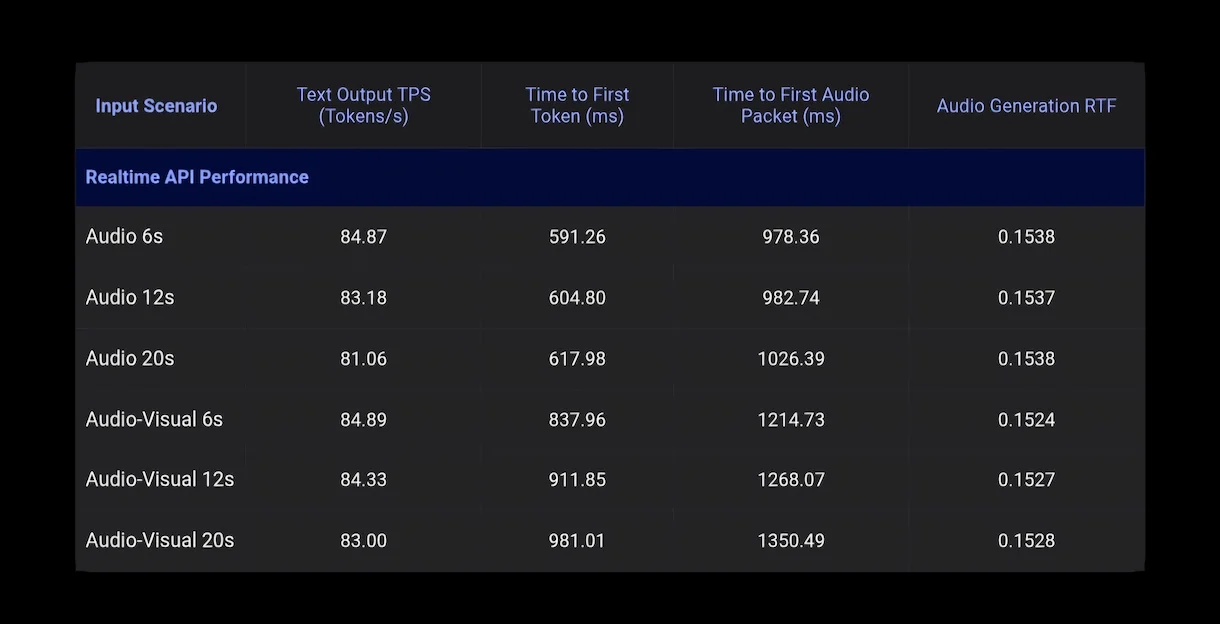
برای تعامل زنده، Qwen3.8-Omni-Flash-Realtime معرفی شده که برای دریافت جریان صوتیتصویری زنده و پاسخ با تأخیر پایین طراحی شده است. این مدل هنگام دریافت جریان، محتوا را درک میکند و با استفاده از زمینه لحظهای میتواند ابزار فراخوانی کند و کار انجام دهد. به این ترتیب، قابلیت چندوجهی از فهم یک محتوای مشخص به مشارکت مستقیم در یک تعامل پیوسته منتقل میشود و زمان واقعی به بخشی از فرایند استدلال تبدیل میشود.
در تمرین مکالمه، مدل باید با ورودیهای غیر استاندارد صوتی مانند لهجه، جابهجایی واکه و همخوان یا تفاوتهای آهنگ گفتار کنار بیاید. Qwen3.8-Omni-Flash-Realtime تلفظ و معنا را بهصورت مشترک مدل میکند، عبارتهای متأثر از لهجه را با واژه درست تطبیق میدهد و نمونه تلفظ استاندارد را در لحظه ارائه میکند. در چند نوبت تمرین نیز با دریافت صوت جدید، خطاهای اثرگذار بر فهم را اصلاح میکند و ریتم، لحن و احساس طبیعی را حفظ میکند.
Qwen3.8-Omni-Flash-Realtime یک قابلیت صوتیتصویری دیگر را نیز برای محیطهای واقعی هدف گرفته است: تعیین جهت و فاصله منبع صدا در کنار درک تصویر. این سامانه میتواند همزمان موانع، مسیرهای قابل پیمایش و تغییرات صحنه را درک کند و هدف را بر اساس صدا مکانیابی کند. Qwen این قابلیت را نخستین مدل چندوجهی معرفی میکند که قادر است با استفاده از صدا، موقعیت هدف را در محیط پیدا کند.
برای دستورهایی مانند «بیا اینجا» یا «برو ببین چه چیزی آن صدا را ایجاد میکند»، مدل میتواند صدا یا صدای هدف را از نویز محیط جدا کند، معنای آن را با فضای اطراف مرتبط سازد و برای مکانیابی، جستوجو، برنامهریزی مسیر و ناوبری ابزار فراخوانی کند. بنابراین زنجیره کار از شنیدن یک هدف آغاز میشود و میتواند تا رسیدن به محل آن ادامه یابد؛ قابلیتی که ادراک صوتی را به اقدام فیزیکی متصل میکند.
تعامل بلادرنگ فقط به کاهش تأخیر محدود نیست و مدل باید بتواند دانش و رفتار مورد نیاز هر برنامه را نیز در لحظه دریافت کند. Qwen3.8-Omni-Flash-Realtime امکان تزریق هویت، سبک بیان، دانش کسبوکار و قواعد تعامل را از طریق Skills فراهم میکند. ابزارها نیز این قابلیتها را به اجرای وظایف متصل میکنند. برای نمونه در خدمات مشتری، مدل میتواند زبان برند و رویههای سرویس را بارگذاری کند، گفتار و تصویر کاربر را بفهمد و مطابق الزامات کسبوکار اقدام کند.
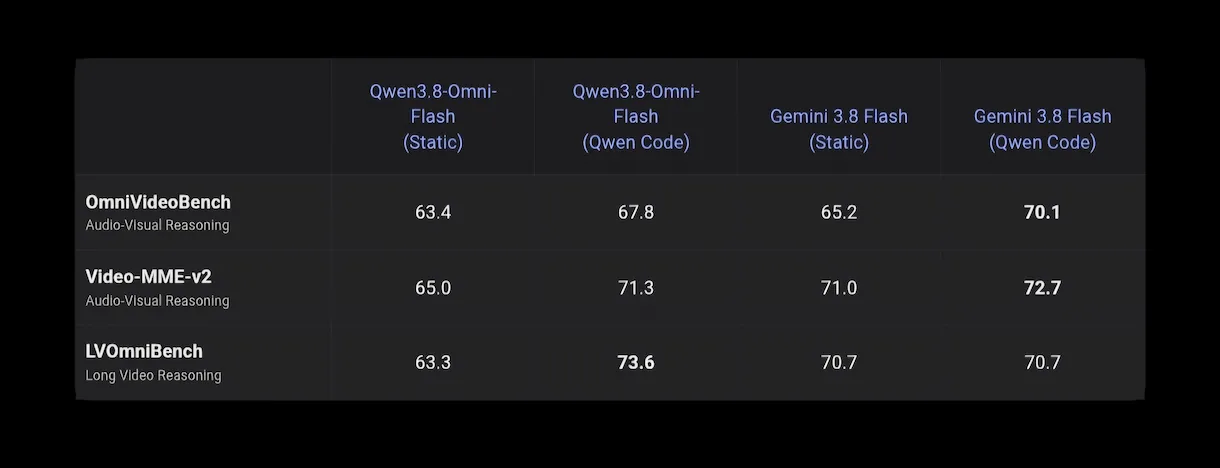
در نتیجه، یک مدل بلادرنگ میتواند بسته به کاربرد، دانش، نقش و شیوه عملکرد متفاوتی داشته باشد. Qwen در ارزیابی درک عاملمحور Omni تأکید میکند اطلاعات مهم در فایلهای طولانی صوتی و ویدیویی ممکن است پراکنده باشند و پرسشهای پیچیده به چند مرحله استدلال میان صدا و تصویر نیاز داشته باشند. مدل از پرسش شروع میکند، مسیر حل را برنامهریزی میکند و شواهد را مرحلهبهمرحله پیدا و بررسی میکند.
برای سنجش این توانایی، Qwen3.8-Omni-Flash و Gemini 3.8 Flash در OmniVideoBench، Video-MME-v2 و LVOmniBench با دو وضعیت مقایسه شدهاند: حالت Static که مدل مستقیماً ورودی را تفسیر میکند و حالت عاملمحور که از Qwen Code استفاده میکند. هدف این مقایسه، بررسی اثر وارد کردن گردشکارهای عاملمحور بر عملکرد مدلها است. Qwen همچنین نتایج توان عملیاتی و تأخیر API مدل بلادرنگ را در شرایط مختلف ورودی گزارش میکند.
در دستورهای مربوط به تولید توضیحات و استخراج اطلاعات از ویدیو، Qwen توصیه میکند شرح تصاویر، OCR، توضیحات صوتی و متن گفتار در بخشهای جداگانه شامل تصویر، گفتار، موسیقی، جلوههای صوتی و صداهای محیطی سازماندهی شوند. متن اصلی، هویت گویندگان و بازههای زمانی مربوطه نیز باید حفظ شوند تا جستوجو و راستیآزمایی آسانتر باشد. تعیین طول هدف در پرامپت، مانند درخواست ۲۰۰۰ تا ۳۰۰۰ کلمه، میتواند سطح جزئیات را با مدت و چگالی اطلاعات ویدیو هماهنگ کند.
برای خروجی ساختاریافته نیز Qwen پیشنهاد میکند دستور کار و یک JSON Schema کامل داخل پرامپت قرار گیرد و معنای فیلدها، نوع داده، فیلدهای الزامی و محدودیتها مشخص شود تا نتیجه برای پردازش برنامهای قابل اتکا باشد. Qwen-MM-Plugins در مجموع مجموعهای از افزونههای چندوجهی برای چارچوبهای عامل است که درک تصویر، صوت، ویدیو و سند، حافظه برای ویدیوهای طولانی و تولید محتوا را در اختیار عامل قرار میدهد.
Qwen-Live Harness نیز یک چارچوب متنباز کامل پیرامون API مدل Qwen3.8-Omni-Flash-Realtime است که با یک فرمان قابل نصب و ادغام با گردشکارهای رایج عاملهاست. این محیط از واگذاری وظیفه، تعامل پیشدستانه، حافظه بلندمدت و مدیریت زمینه پشتیبانی میکند و مانند Qwen-MM-Plugins پذیرای مشارکت جامعه توسعهدهندگان است. Qwen میگوید درخواستهای این پروژه را میتوان مستقیماً در عامل اداری معمول کاربر وارد کرد.