گوگل دو مدل صوتی جدید Gemini 3.8 Live و نسخهی Extended Thinking را معرفی کرد
گوگل دو مدل صوتی جدید Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking را معرفی کرده است؛ مدلهایی که با تمرکز بر استدلال تقریباً بلادرنگ، مکالمه طبیعیتر و اجرای وظایف پیچیده با صدا طراحی شدهاند. نسخه لایو برای مقیاسپذیری و کاهش هزینه ساخته شده و همزمان هوش مکالمهای، گفتوگوی روان و درک بصری را ارائه میکند. نسخه Extended Thinking نیز برای کارهای پیچیدهتر و استدلال چندمرحلهای توسعه یافته است.
Gemini 3.8 Live Extended Thinking در شاخص کیفیت گفتار به گفتار Artificial Analysis با امتیاز ۸۲.۶ رتبه نخست را به دست آورده و در تکمیل وظایف عاملمحور نیز عملکرد قابلتوجهی دارد. این مدل در τ-Voice امتیاز ۶۸.۶ درصد و در معیار بانکی τ-Voice شرکت Sierra امتیاز ۳۵.۱ درصد گرفته است. همچنین امتیاز ۹۷.۷ درصد در Big Bench Audio را ثبت میکند و در مقایسه با مدلهای پیشرفته، قیمت رقابتی دارد.
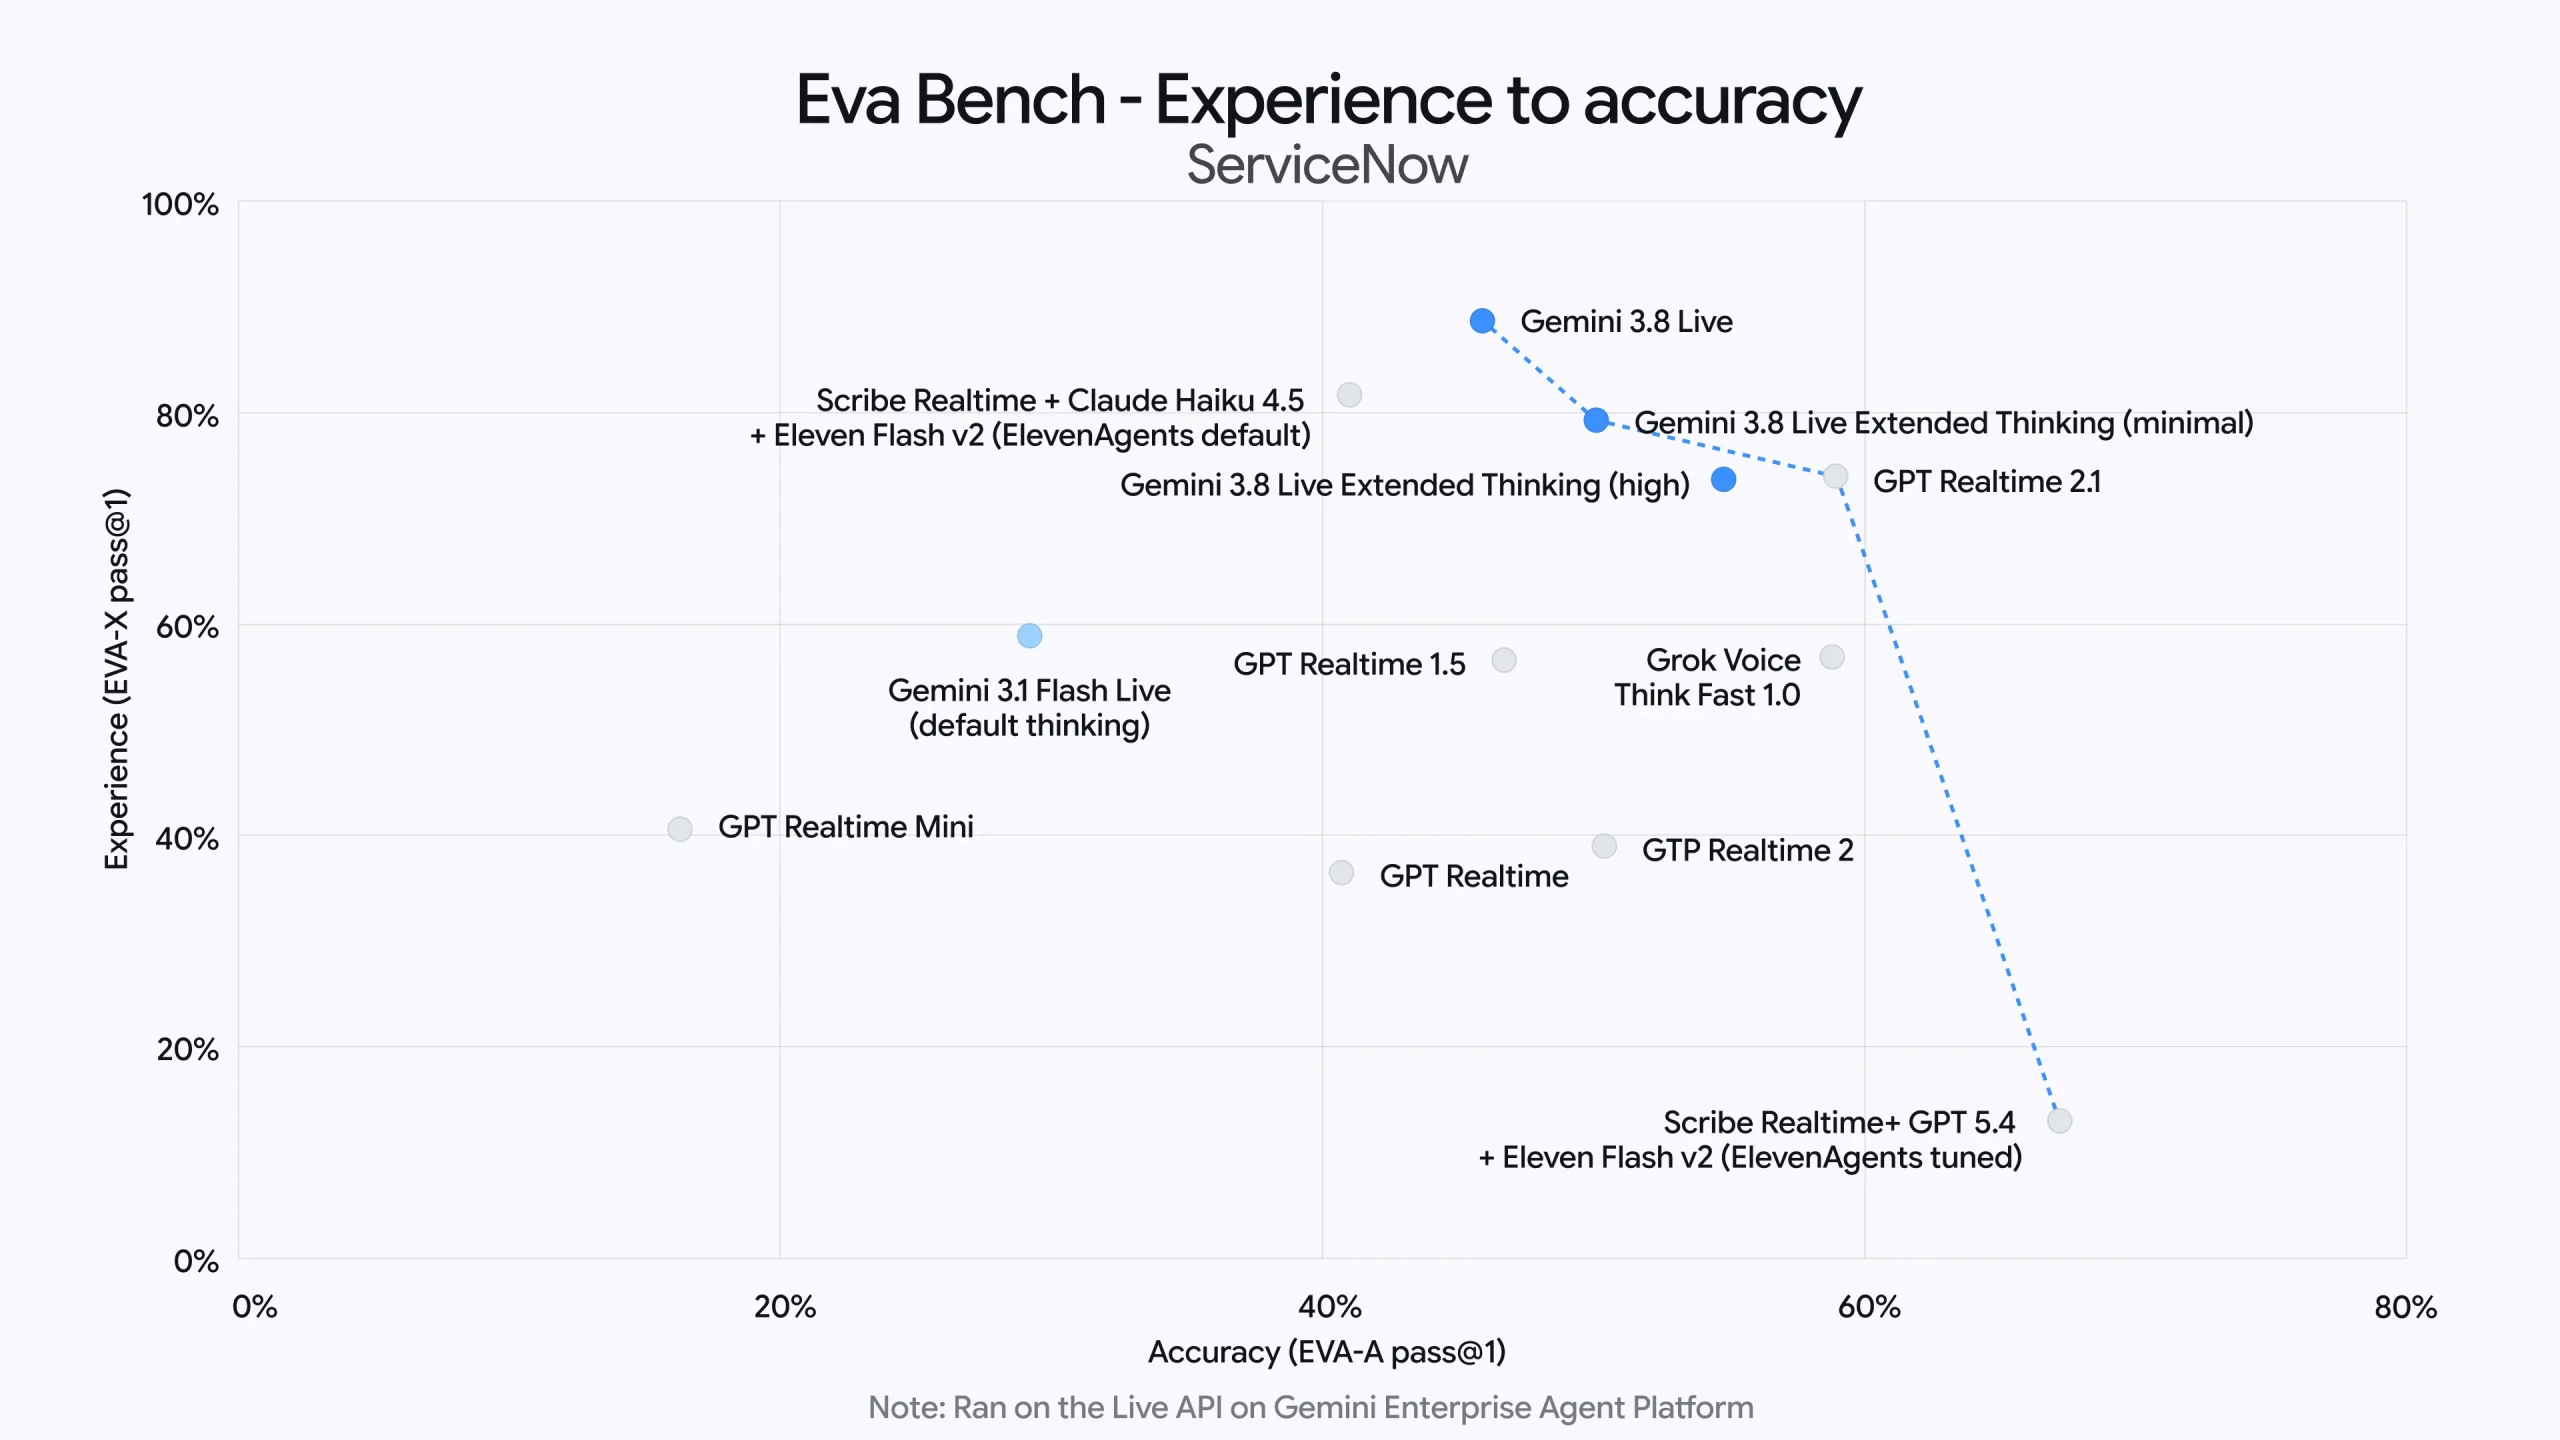
نسخه معمولی Gemini 3.8 Live نیز در Speech Agent Arena جایگاه دوم را کسب کرده است. گوگل میگوید این مدل در کنار این عملکرد، هزینهبر بودن را کنترل میکند و گزینهای توانمند و کارآمد برای توسعهدهندگان و سازمانهایی است که به دنبال ساخت عاملهای صوتی در مقیاس بالا هستند. در EVA-Bench سرویس ServiceNow نیز هر دو مدل در گردشکارهای پیچیده، مرز پارتو میان دقت و کیفیت مکالمه را جابهجا کردهاند.
Gemini 3.8 Live میتواند ورودیهای بصری را تقریباً بهصورت بلادرنگ پردازش کند تا پاسخها را با زمینه بیشتری ارائه دهد. این مدل همچنین قادر است هنگام ادامه مکالمه، بهطور خودکار میان ۹۷ زبان پشتیبانیشده جابهجا شود. اجرای ابزارها و فراخوانی API نیز در پسزمینه انجام میشود؛ بنابراین مدل میتواند ضمن تأیید درخواست کاربر و ادامه گفتوگو، منتظر پایان فرآیندهای اجرایی نماند و وظایف را همزمان پیش ببرد.
برای کارهایی که به استدلال عمیقتر نیاز دارند، Gemini 3.8 Live Extended Thinking میتواند همزمان با فکر کردن، صحبت کند. مدل برای حفظ جریان طبیعی مکالمه، درخواست را با عبارتهایی مانند «اجازه بده بررسی کنم…» تأیید میکند و در جریان وظایف چندمرحلهای پسزمینه، پیشرفت کار را بهصورت زنده توضیح میدهد. گوگل میگوید این قابلیت برای گردشکارهای پیچیده، هوش بیشتر را بدون قطع شدن روند گفتوگو فراهم میکند.
گوگل این مدلهای Live را در Gemini، Workspace و Search نیز به کار گرفته تا تجربه همکاری و انجام کارهای پیچیده با صدا طبیعیتر شود. در بخش توسعهدهندگان، پلتفرمهایی مانند Agora، Fishjam، LangChain، LiveKit، Pipecat، Vercel و Vision Agents از Gemini Live API برای ساخت رابطهای صوتی استفاده میکنند. این پلتفرمها زیرساخت پیچیده استریم رسانهای بلادرنگ را مدیریت میکنند تا توسعهدهندگان روی تجربه کاربری تمرکز کنند.
گوگل همچنین با Salesforce، Genspark و Lumeris همکاری دارد و آنها به قابلیتهای Gemini 3.8 Live و نسخه Extended Thinking، بهویژه در زمینه تأخیر کم، روانی مکالمه و فراخوانی ابزارها، ابراز علاقه کردهاند. از سوی دیگر، تمامی فایلهای صوتی تولیدشده توسط محصولات هوش مصنوعی گوگل با SynthID واترمارک میشوند. این واترمارک نامرئی مستقیماً در خروجی صوتی قرار میگیرد تا امکان شناسایی محتوای تولیدشده با هوش مصنوعی و مقابله با اطلاعات نادرست فراهم شود.
عرضه جمنای ۳.۸ لایو برای توسعهدهندگان در Gemini API و Google AI Studio آغاز شده است. این مدل برای سازمانها در Gemini Enterprise بهصورت پیشنمایش خصوصی ارائه میشود و بهزودی به Gemini Enterprise for Customer Experience میآید؛ کاربران عمومی نیز آن را در Search Live دریافت میکنند. نسخه Extended Thinking نیز در Gemini API و Google AI Studio برای توسعهدهندگان و بهصورت پیشنمایش خصوصی در Gemini Enterprise در دسترس است.
نسخه Extended Thinking برای مشتریان تجاری Google Workspace نیز عرضه میشود و برای کاربران عمومی در Gemini Live در دسترس قرار دارد. همچنین مشترکان Google AI Pro و Ultra میتوانند از آن در Docs و تمامی مشترکان Google AI در Gmail و Keep استفاده کنند. گوگل برای جزئیات درباره رویکرد ایمنی و مسئولیتپذیری، کاربران را به Model Card ارجاع میدهد و تأکید کرده است که مدلهای جدید، بلوکهای سازنده عاملهای صوتی آماده تولید را فراهم میکنند.