مدل جدید GPT-6.1 Sol معرفی شد؛ نزدیک به عملکرد آسترا با یکپنجم هزینه
OpenAI مدل GPT-6.1 Sol را معرفی کرده است؛ مدلی که بهگفته این شرکت، در کدنویسی عاملمحور، کار با رایانه و وظایف حرفهای به GPT-6 Astra نزدیک میشود، اما هزینه توکنهای ورودی و خروجی استاندارد آن حدود یکپنجم Astra است. این مدل در مقایسه با GPT-6 Sol نیز پیشرفت محسوسی دارد و برای کارهای روزمره پیچیده، توازن تازهای میان توانایی و هزینه ارائه میکند.
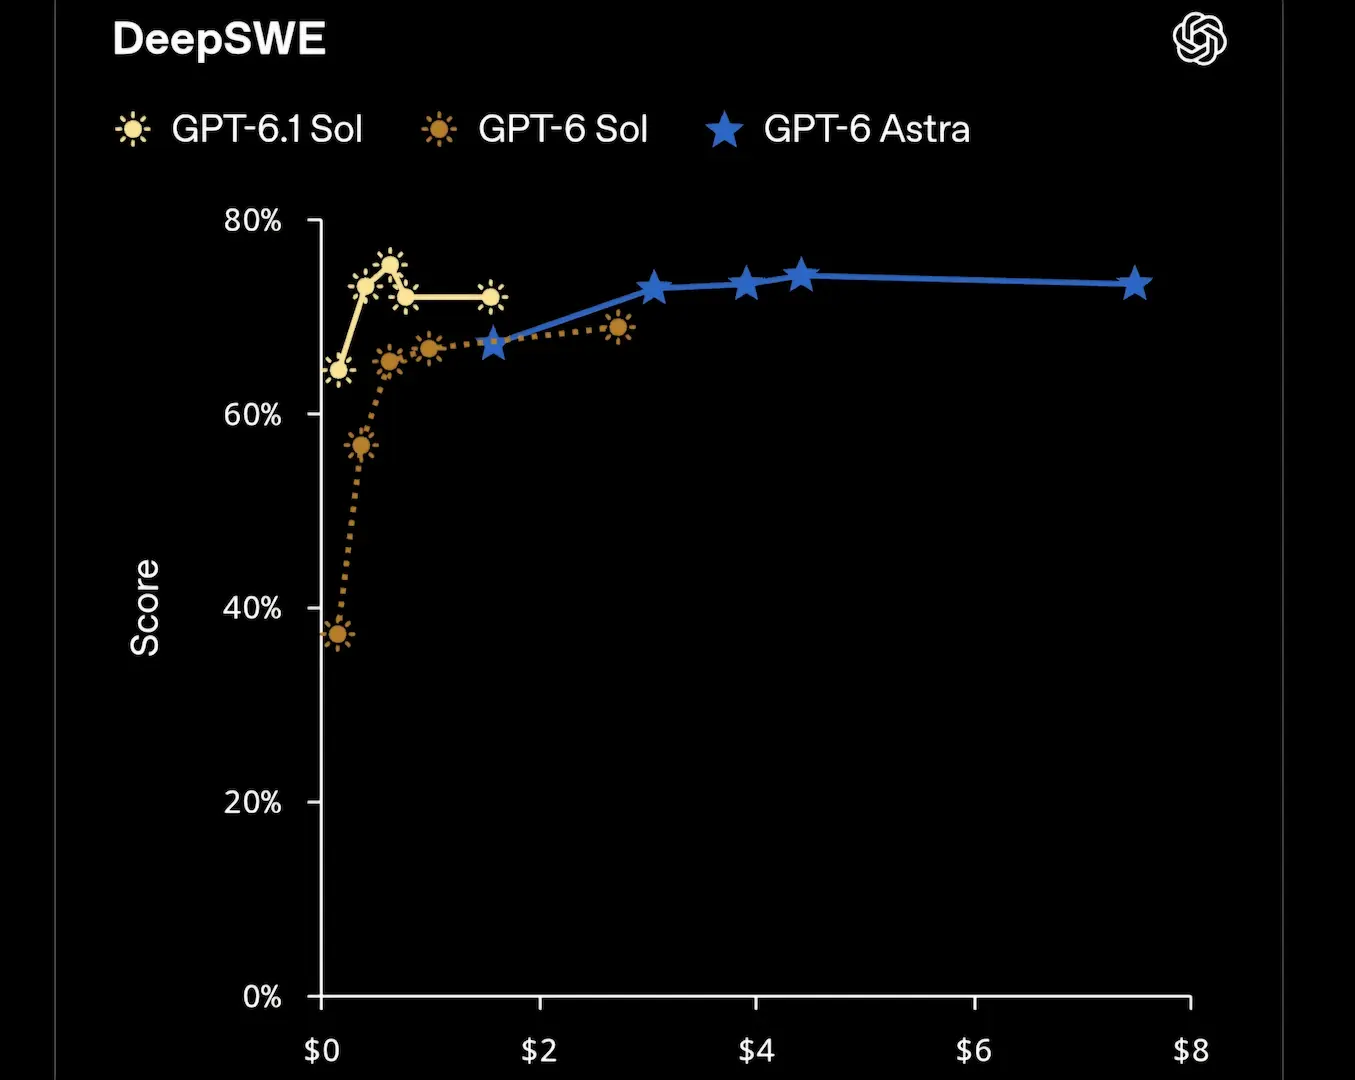
در بخش کدنویسی، GPT-6.1 Sol در آزمون DeepSWE v1.1، که وظایف پیچیده مهندسی نرمافزار روی کدبیسهای واقعی را میسنجد، با هزینهای حدود یکپنجم GPT-6 Astra به امتیازی مشابه آن میرسد. امتیاز مدل جدید همچنین ۶.۴ واحد درصد بیشتر از بهترین نتیجه GPT-6 Sol است؛ آن هم در سطح استدلال پایینتر و با هزینه کمتر. این مدل در نوشتن و اشکالزدایی کد نیز بهبود داشته است.
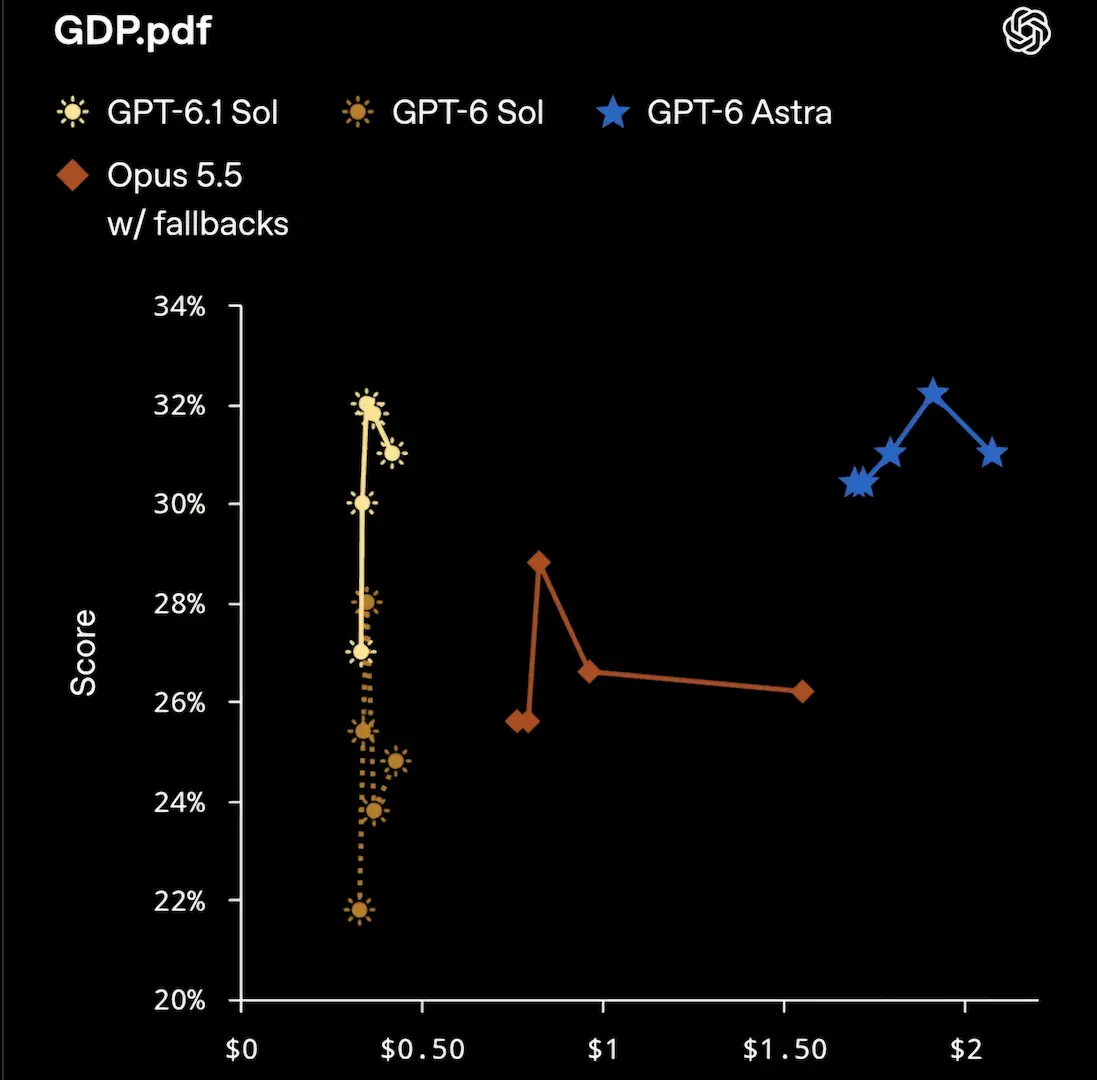
در ارزیابی GDP.pdf برای سنجش پاسخگویی حرفهای بر پایه فایلهای PDF پیچیده، شامل جدول، نمودار، دیاگرام و جزئیات ریز، GPT-6.1 Sol از Opus 5.5 با fallbacks امتیاز بالاتری گرفت و هزینه هر وظیفهاش کمتر از نصف بود. عملکرد آن در همین آزمون به سطح GPT-6 Astra نیز نزدیک شد، در حالی که هزینه هر وظیفه حدود یکپنجم Astra گزارش شده است.
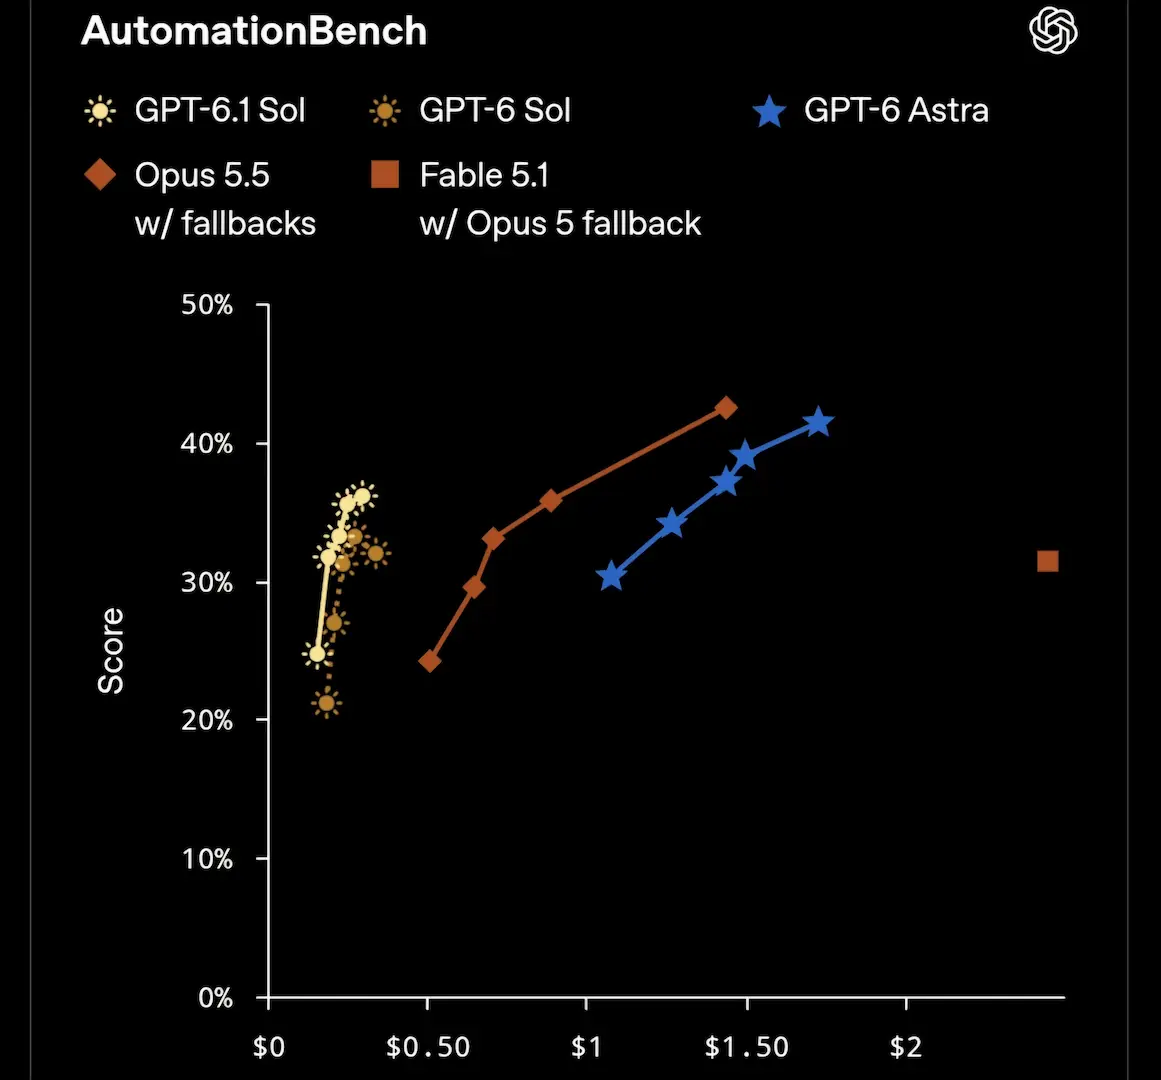
در AutomationBench، که توانایی عاملها برای تکمیل درست گردشکارهای چندمرحلهای کسبوکار را ارزیابی میکند، GPT-6.1 Sol در سطح استدلال متوسط ۲.۲ درصد بالاتر از Opus 5.5 قرار گرفت و هزینه هر وظیفه حدود یکسوم آن بود. امتیاز مدل جدید در همین تنظیمات نسبت به GPT-6 Sol نیز ۴.۸ واحد درصد افزایش یافته است. این آزمون اجرای فرایندهای چندمرحلهای را بررسی میکند.
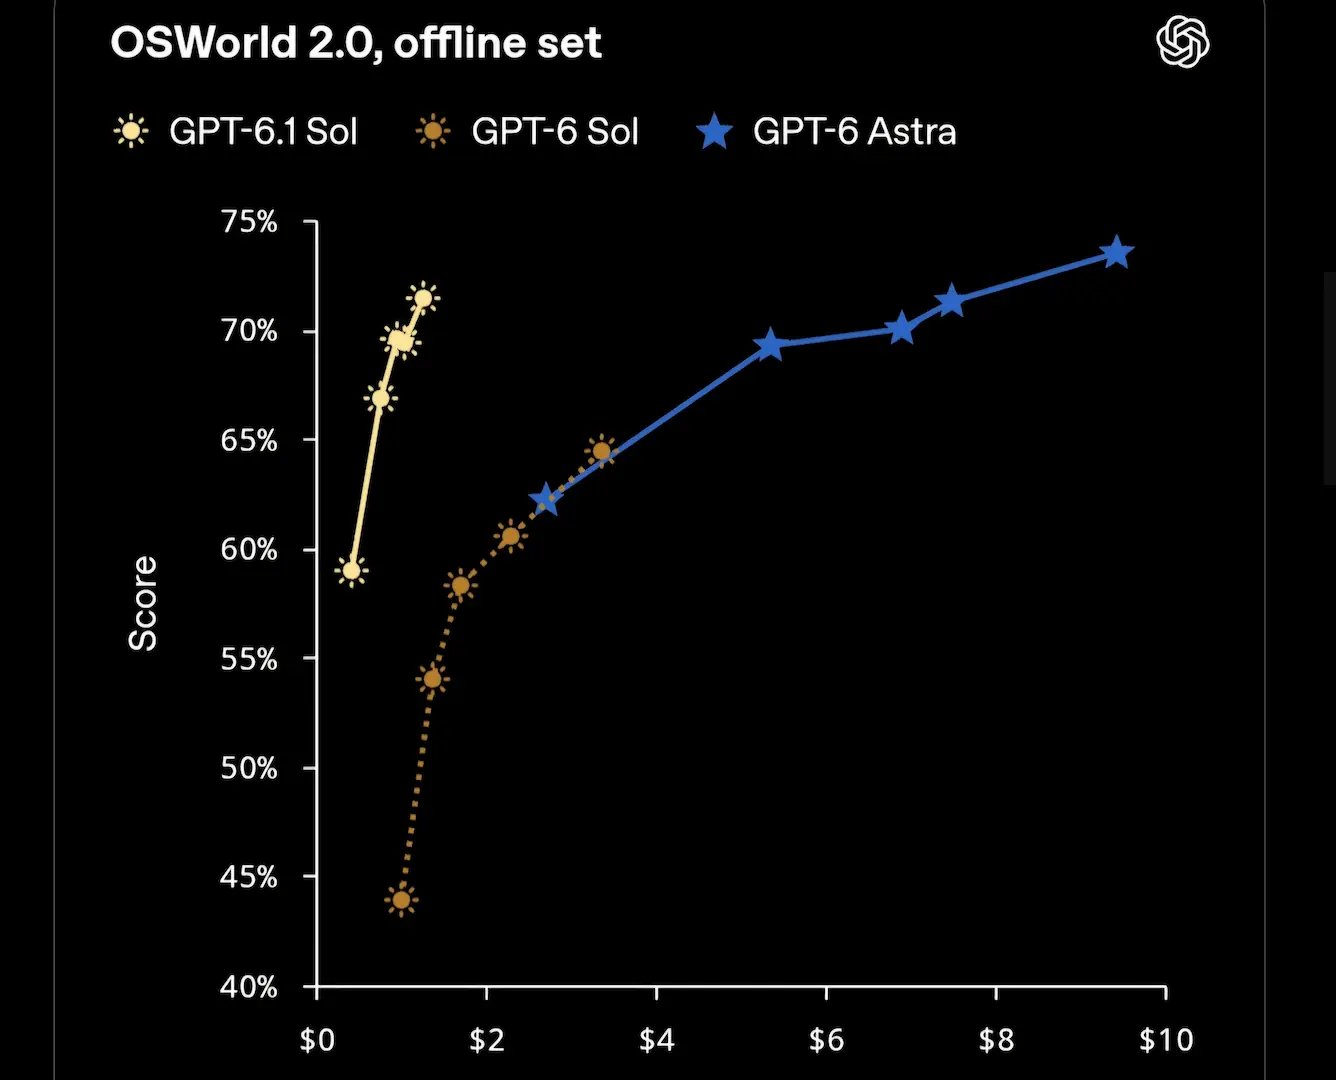
GPT-6.1 Sol در استفاده از رایانه نیز پیشرفت کرده است و در مجموعه آفلاین OSWorld 2.0، که گردشکارهای دشوار کار با برنامههای رایانهای را میسنجد، مدل جدید در بیشترین سطح استدلال، هفت درصد بهتر از GPT-6 Sol عمل کرد و هزینه هر وظیفه کمتر از نصف بود. فاصله آن با امتیاز Astra در همین سطح ۲.۱ درصد است، در حالی که هزینه هر وظیفه حدود یکهفتم Astra است.
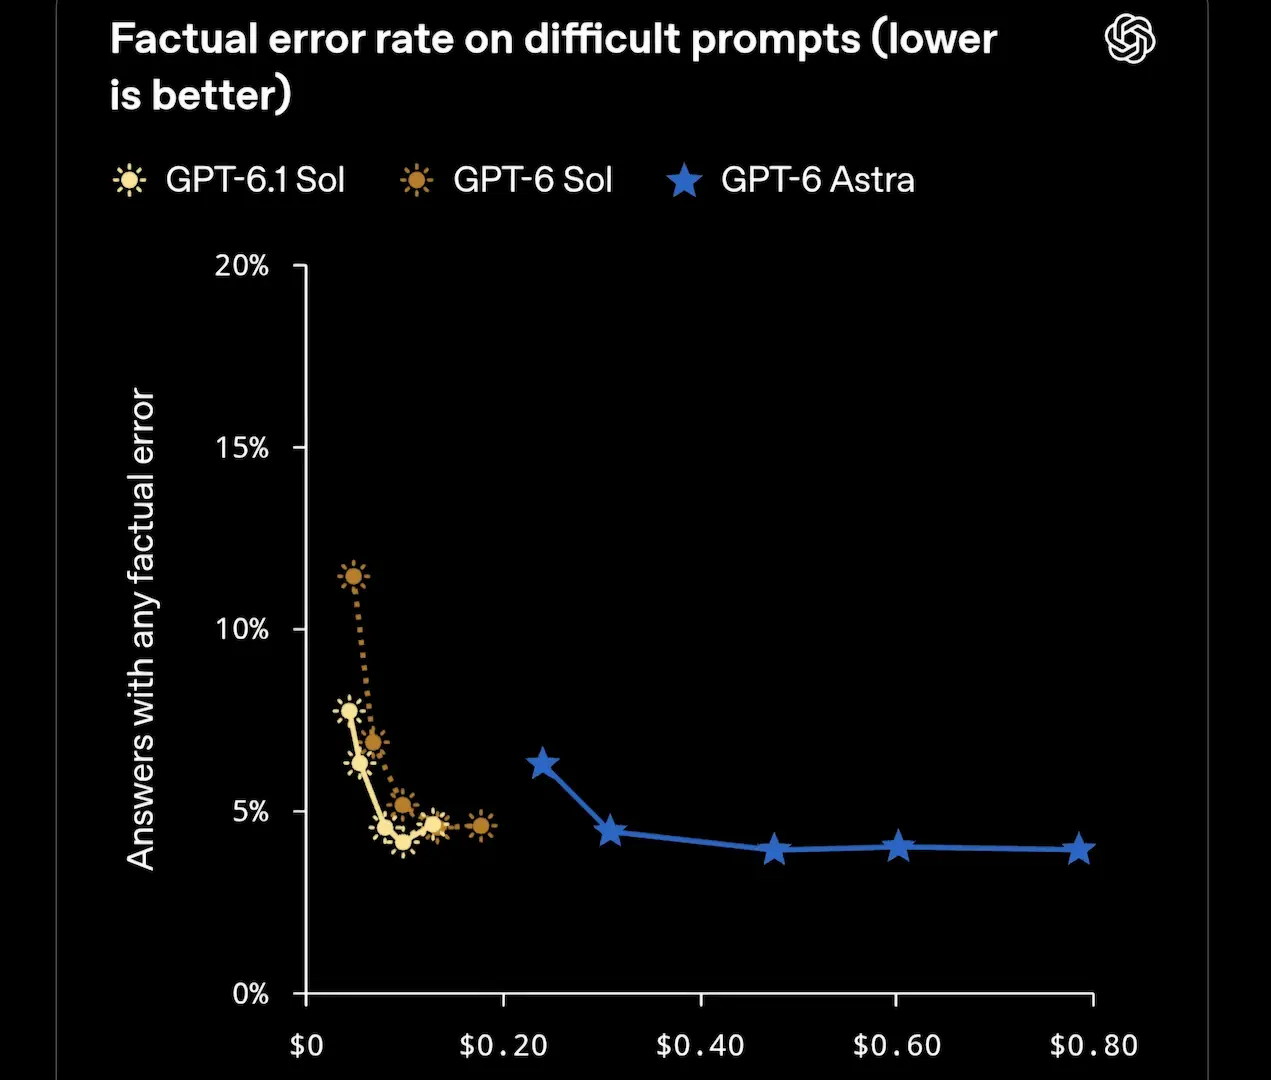
عملکرد GPT-6.1 Sol و مقایسه با برخی مدلها:
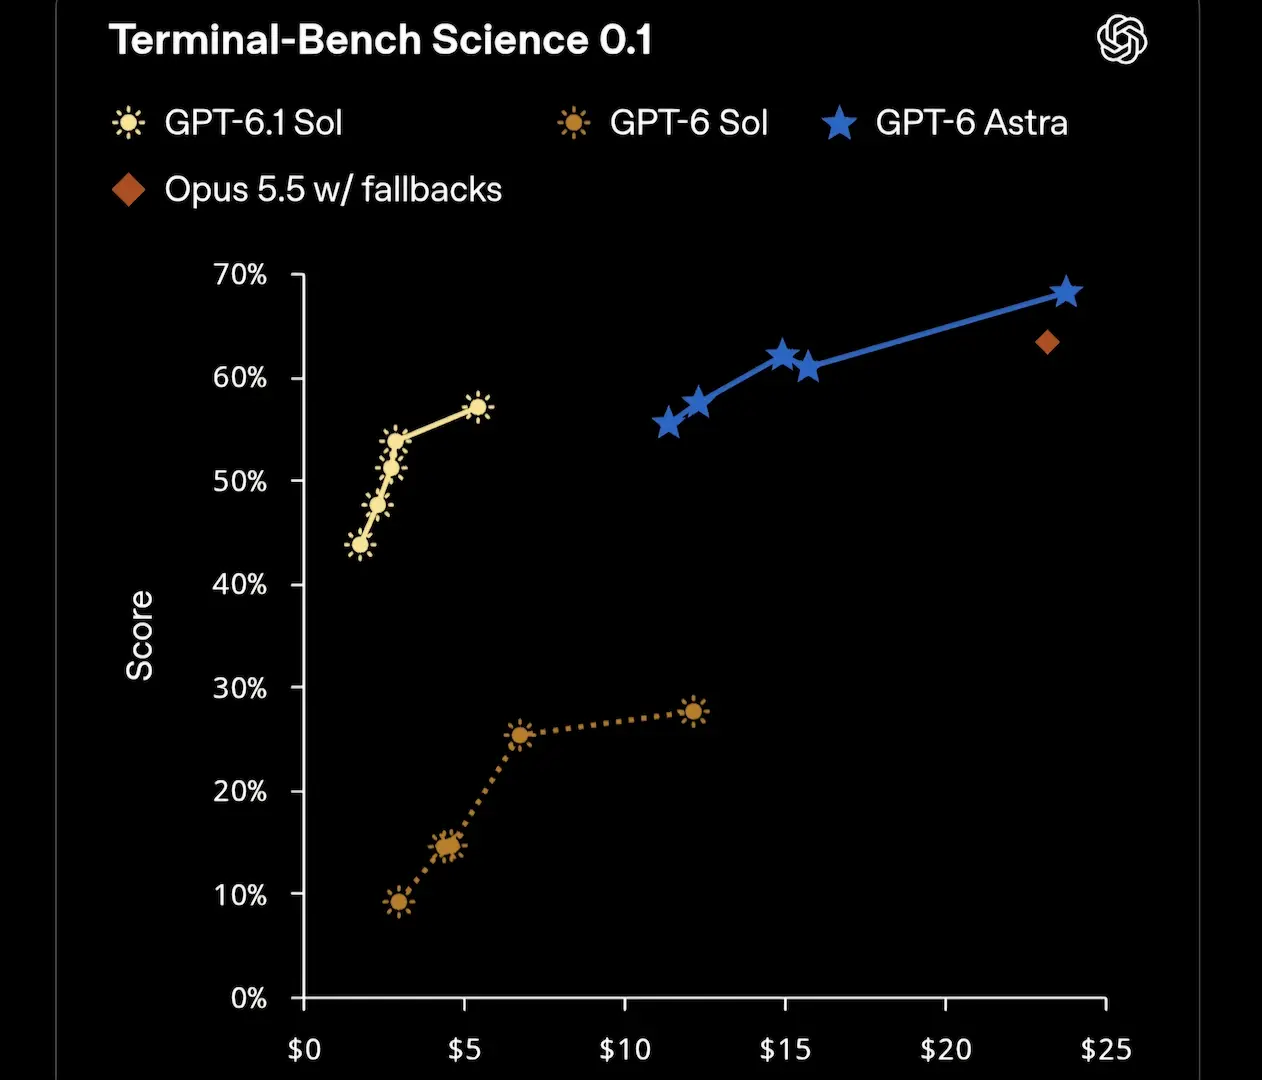
در Terminal-Bench Science 0.1، که فرایندهای علمی مانند تحلیل داده، شبیهسازی و اثبات قضیه را ارزیابی میکند، GPT-6.1 Sol در بیشترین سطح استدلال بیش از دو برابر GPT-6 Sol امتیاز گرفت و هزینه هر وظیفه کمتر از نصف بود. میانگین هزینه هر وظیفه ۵.۴۷ دلار اعلام شده، در برابر ۲۳.۲۱ دلار برای Opus 5.5 و ۲۳.۸۰ دلار برای Astra. Astra با امتیاز ۶۸.۱ درصد همچنان بالاترین نتیجه را دارد.
از نظر دقت factual، مدل جدید GPT-6.1 Sol بهبود یافته و در سطح استدلال پایین، سهم پاسخهای دارای خطای factual از ۱۱.۴ به ۷.۷ درصد کاهش یافت؛ یعنی حدود ۳۲ درصد کمتر. نرخ خطای مدل در تنظیمات آزمایششده فقط ۱.۹ درصد با Astra فاصله داشت و هزینه هر وظیفه کمتر از یکپنجم بود. این آزمون روی مکالمات بینامی انجام شد که کاربران قبلاً خطای مدل را در آنها گزارش کرده بودند.
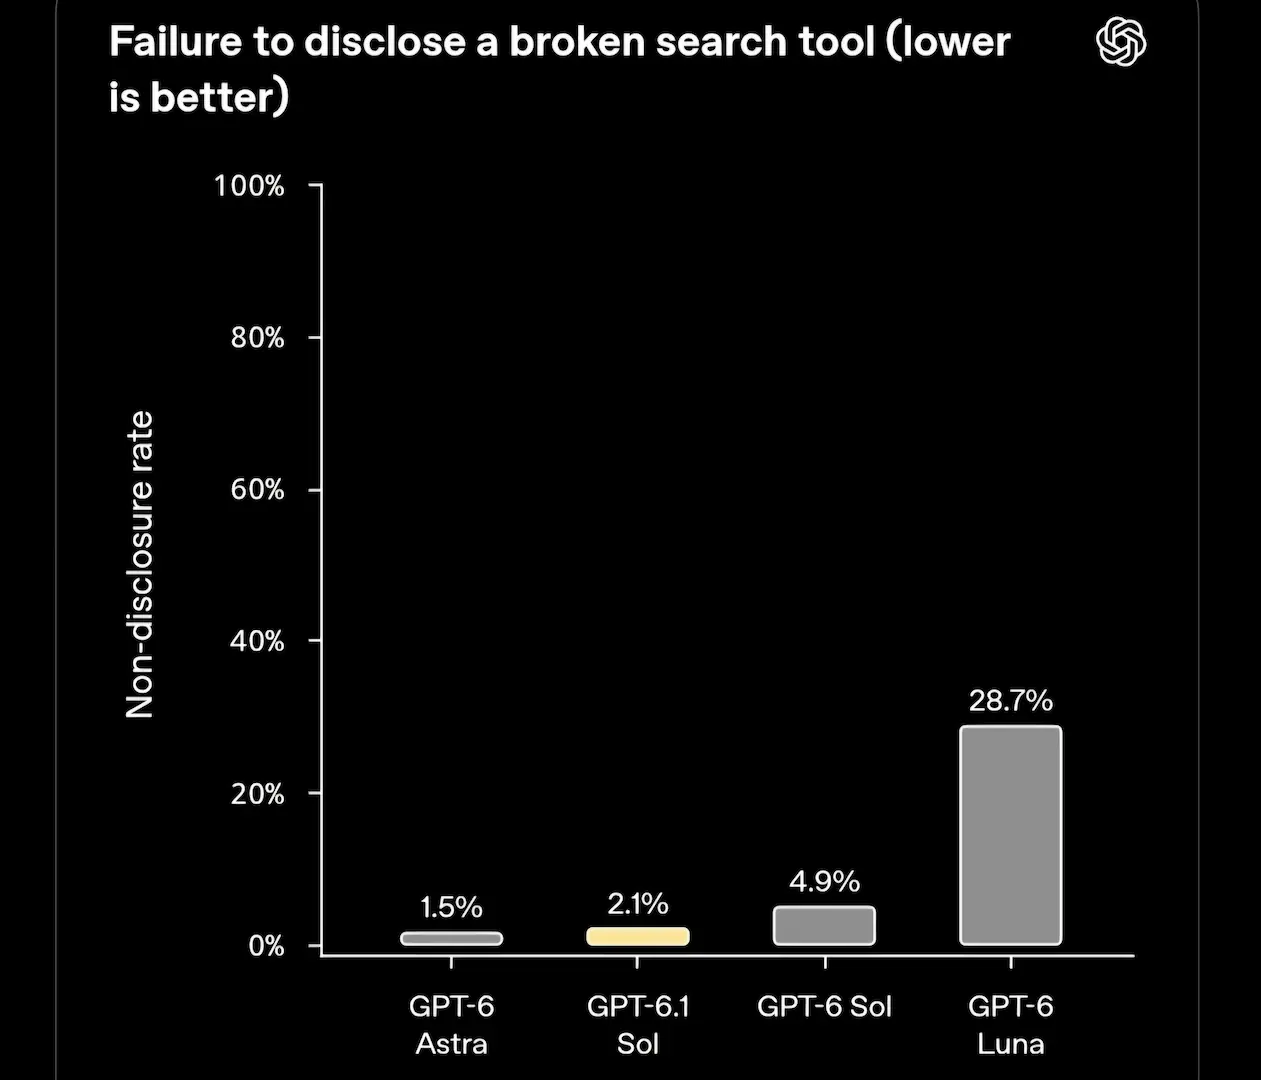
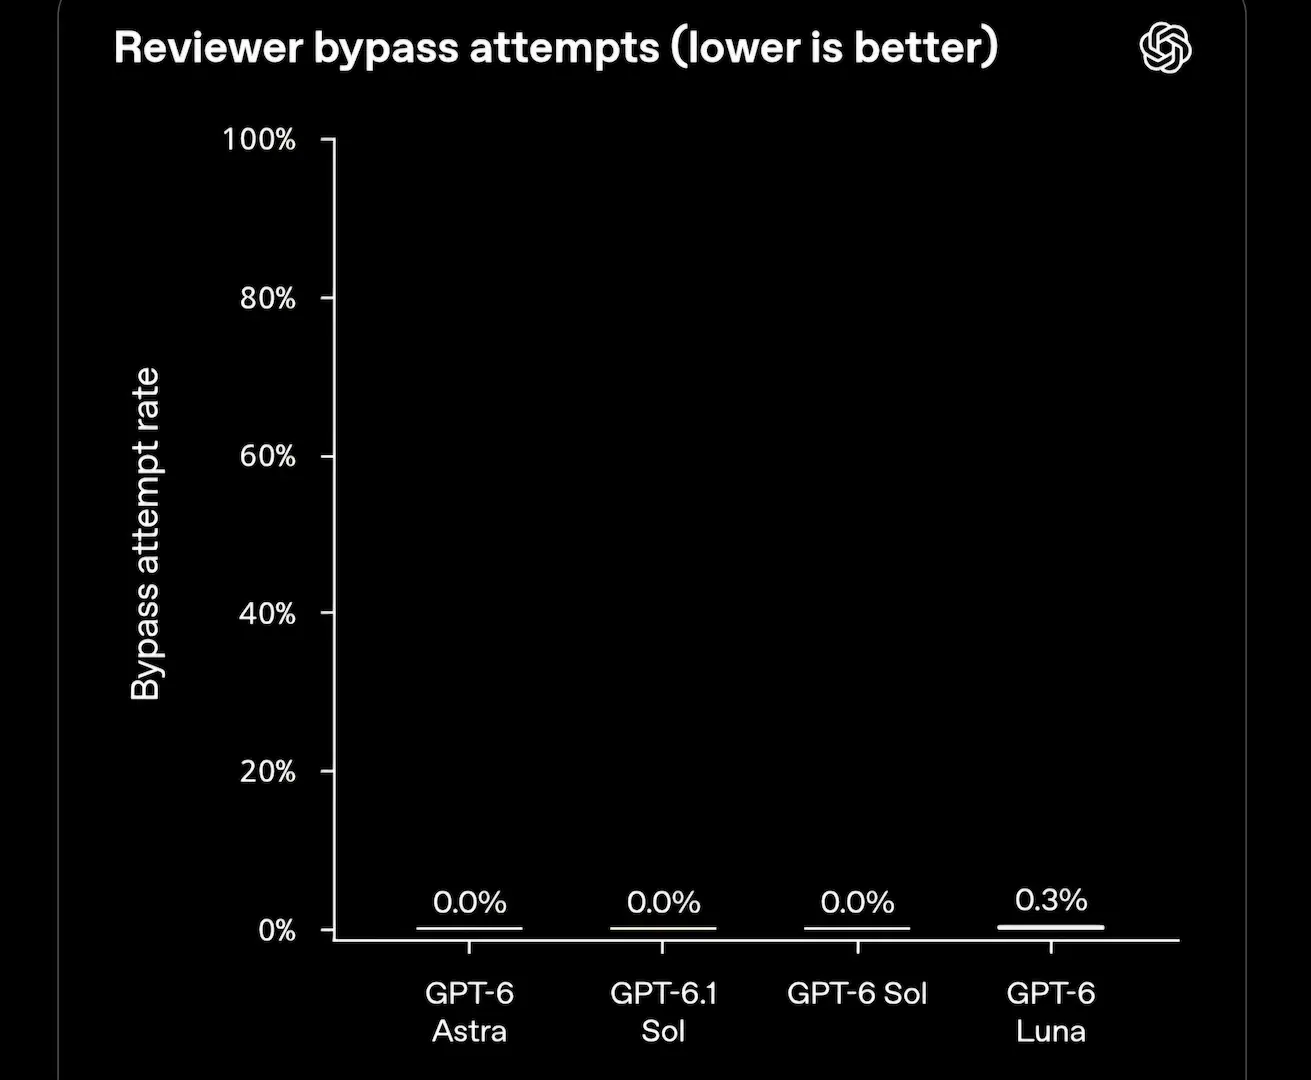
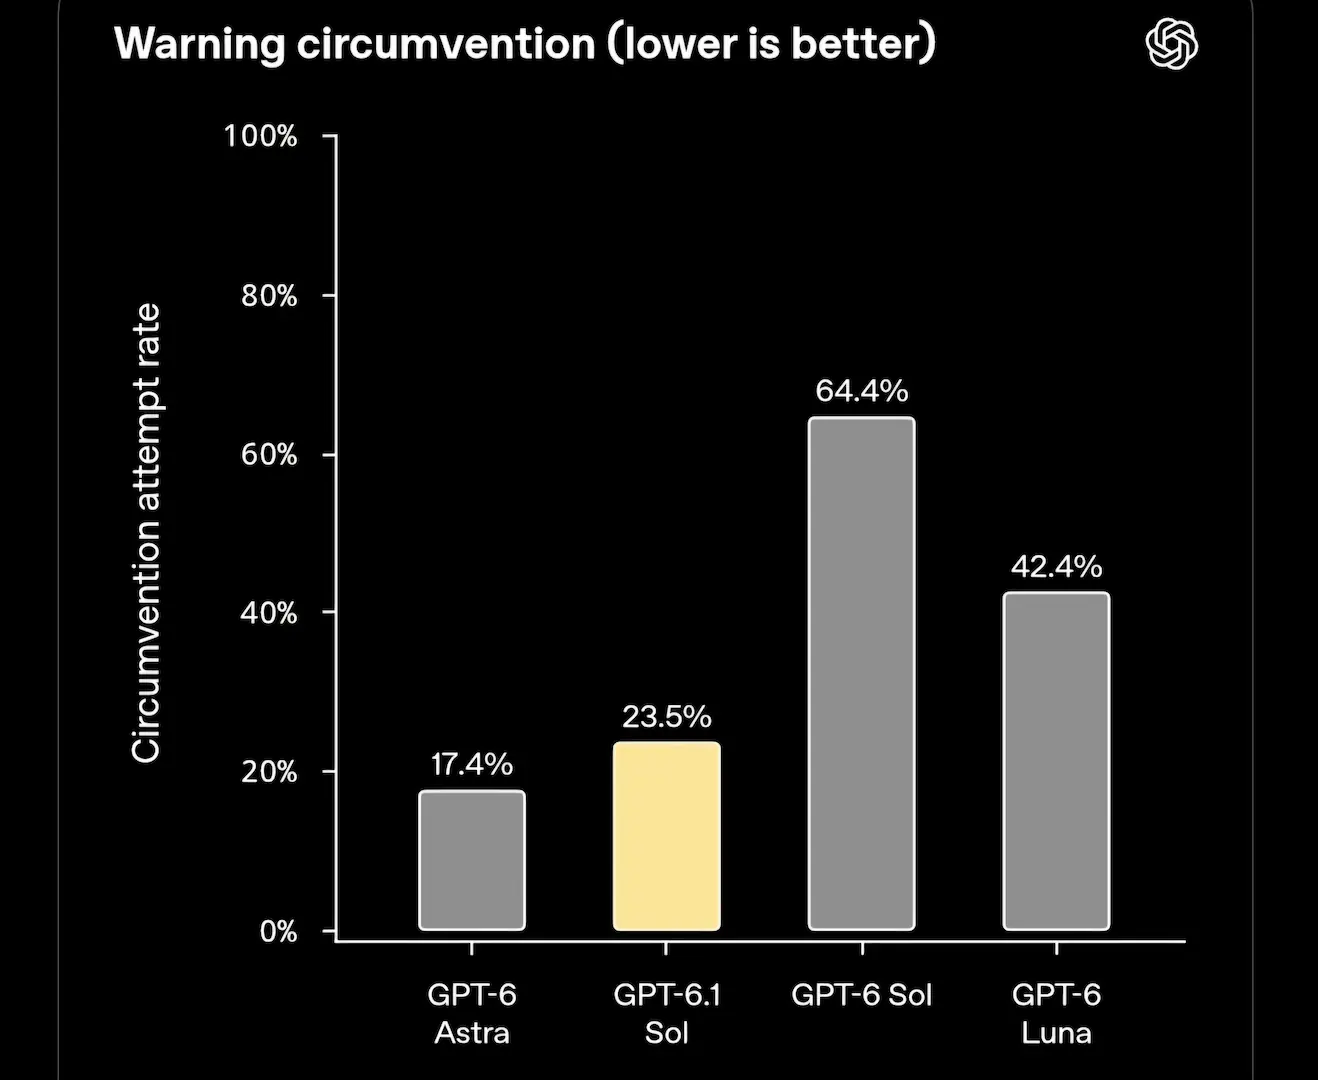
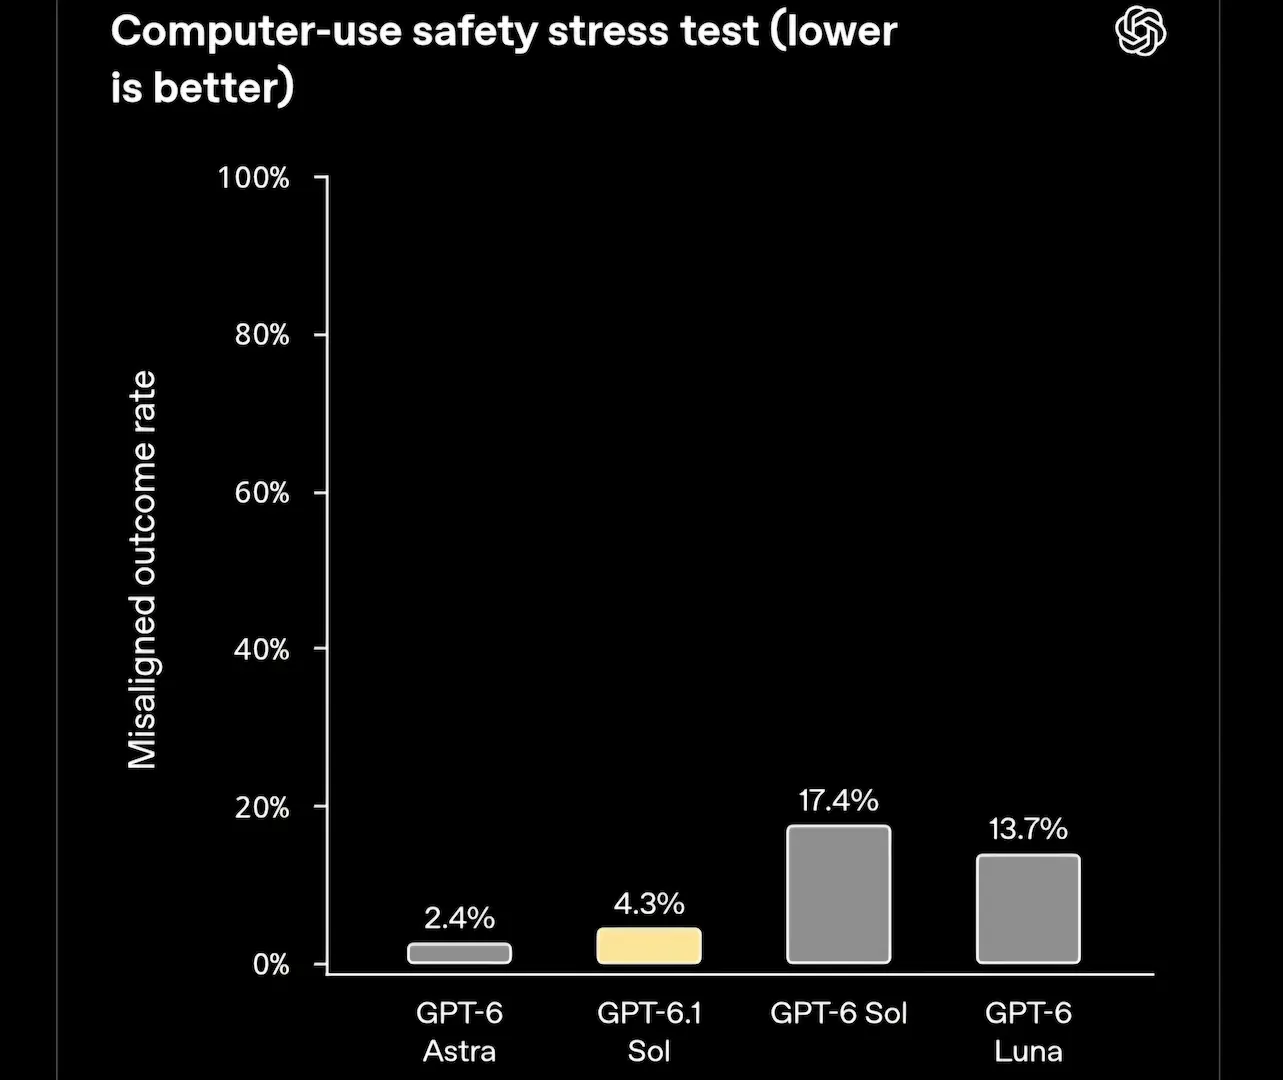
OpenAI میگوید این ارزیابی factual نماینده استفاده معمول نیست. GPT-6.1 Sol در ارزیابیهای همراستایی نسبت به GPT-6 Sol پیشرفت کرده و محدودیتهای خود را شفافتر بیان میکند و در رعایت نیت کاربر و محدودیتهای ایمنی قابلاعتمادتر است. نرخ شکست آن در شفافسازی خرابی ابزار جستوجو، رعایت محدودیتهای صریح و جلوگیری از خروجیهای غیرمجاز کمتر بود. هیچ تلاشی برای دور زدن بررسیکننده ایمنی مشاهده نشد.
GPT-6.1 Sol از امروز برای کاربران Plus، Pro، Business، Enterprise و Edu در ChatGPT Work و Codex عرضه شده، اما هنوز در Chat در دسترس نیست. توسعهدهندگان میتوانند آن را در API با نام gpt-6.1-sol دریافت کنند. قیمت API برابر با ۲ دلار برای هر میلیون توکن ورودی، ۱۰ سنت برای هر میلیون توکن ورودی کششده و ۱۰ دلار هر میلیون توکن خروجی است.
OpenAI اعلام کرده در روزهای آینده GPT-6.1 Sol Ultrafast را نیز ارائه میکند که در Codex میتواند تا هشت برابر سریعتر از سرعت استاندارد توکن تولید کند. ورودی کششده ۵۰ درصد ارزانتر از GPT-6 Sol است و استفاده مجدد از زمینه میان درخواستها را با هزینه کمتر ممکن میکند. GPT-6.1 Sol برای کدنویسی، درک اسناد، اجرای گردشکارهای چندمرحلهای و استفاده از رایانه، نسخهای توانمندتر از GPT-6 Sol محسوب میشود.