کلاد Opus 5.5 معرفی شد؛ مدل جدید Anthropic با هزینه ۴۰ درصد کمتر و برابر با Fable 5.1
آنتروپیک نخستین عضو خانواده Claude 5.5 را با نام Claude Opus 5.5 معرفی کرد؛ مدلی که به گفته شرکت در بیشتر کارها به سطح Claude Fable 5.1 میرسد، اما هزینه اجرای آن حدود ۴۰ درصد کمتر از Opus 5 است. Opus 5.5 همچنین در جامعترین ارزیابی رفتاری خودکار Anthropic، بهترین عملکرد ثبتشده میان مدلهای آزمایششده این شرکت را به دست آورده است.
این مدل پیش از عرضه توسط ارزیابانی مانند METR و Frontier Design نیز بررسی شده است و آنتروپیک میگوید Opus 5.5 در برنامهنویسی عاملمحور، استفاده از رایانه و کارهای دانشمحور پیشرفت کرده و یک آزمایشکننده مهاجرت کدی ۶۸۰ هزار خطی را در کمتر از یک روز انجام داده است؛ کاری که میتوانست چند هفته زمان یک تیم مهندسی را نیاز داشته باشد.
اوپوس ۵.۵ یک کدبیس ۲۰۰ هزار خطی را در کمتر از سه ساعت ممیزی و اصلاح کرد، در حالی که Opus 5 بیش از ۲۰ ساعت زمان برد و ۲.۵ برابر توکن بیشتری مصرف کرد. مدل جدید همچنین در کاهش زمان بارگذاری صفحات یک اپلیکیشن وب، در ۳۹ مورد از ۴۰ تلاش موفق شد. Opus 5 بهبودهای کوچکتری ایجاد کرد که گاهی رفتار اپلیکیشن را نیز تغییر میداد.
در آزمایشی دیگر، چند مدل Claude مأمور ساخت یک بازی از یک دستور واحد شدند و Opus 5.5 از نظر گرافیک بالاترین امتیاز را گرفت. هزینه استفاده از مدل جدید نیز کاهش یافته است و قیمت ورودی برای هر یک میلیون توکن ۴ دلار و خروجی ۲۰ دلار است؛ هر دو رقم ۲۰ درصد کمتر از Opus 5 هستند. هزینه Cache Read نیز به ۰.۲ دلار برای هر یک میلیون توکن رسیده است.
Cache Read نسبت به Opus 5 حدود ۶۰ درصد ارزانتر شده و برای کارهای عاملمحور و برنامهنویسی اهمیت دارد. Anthropic میگوید Opus 5.5 بیش از ۳۰ درصد سریعتر از نسل قبل خروجی تولید میکند. حالت Fast نیز در Claude Code و Claude Platform با سرعتی تا ۲.۵ برابر ارائه میشود و قیمت آن برای هر یک میلیون توکن ورودی ۸ دلار و برای خروجی ۴۰ دلار است.
آنتروپیک محدودیتهای استفاده پنجساعته در طرحهای پرو، مکس و Team را افزایش میدهد و به کاربران اشتراکی اجازه میدهد یک Rate Limit Reset را ذخیره کنند. در آزمایش ترجمه HAProxy از C به Rust، اوپوس ۵.۵ و Fable 5.1 تقریباً تمام آزمونهای رگرسیون را پشت سر گذاشتند؛ با این حال، مدل جدید کار را در ۹.۵ ساعت تمام کرد و هزینه اجرای آن ۵۱ درصد کمتر بود.
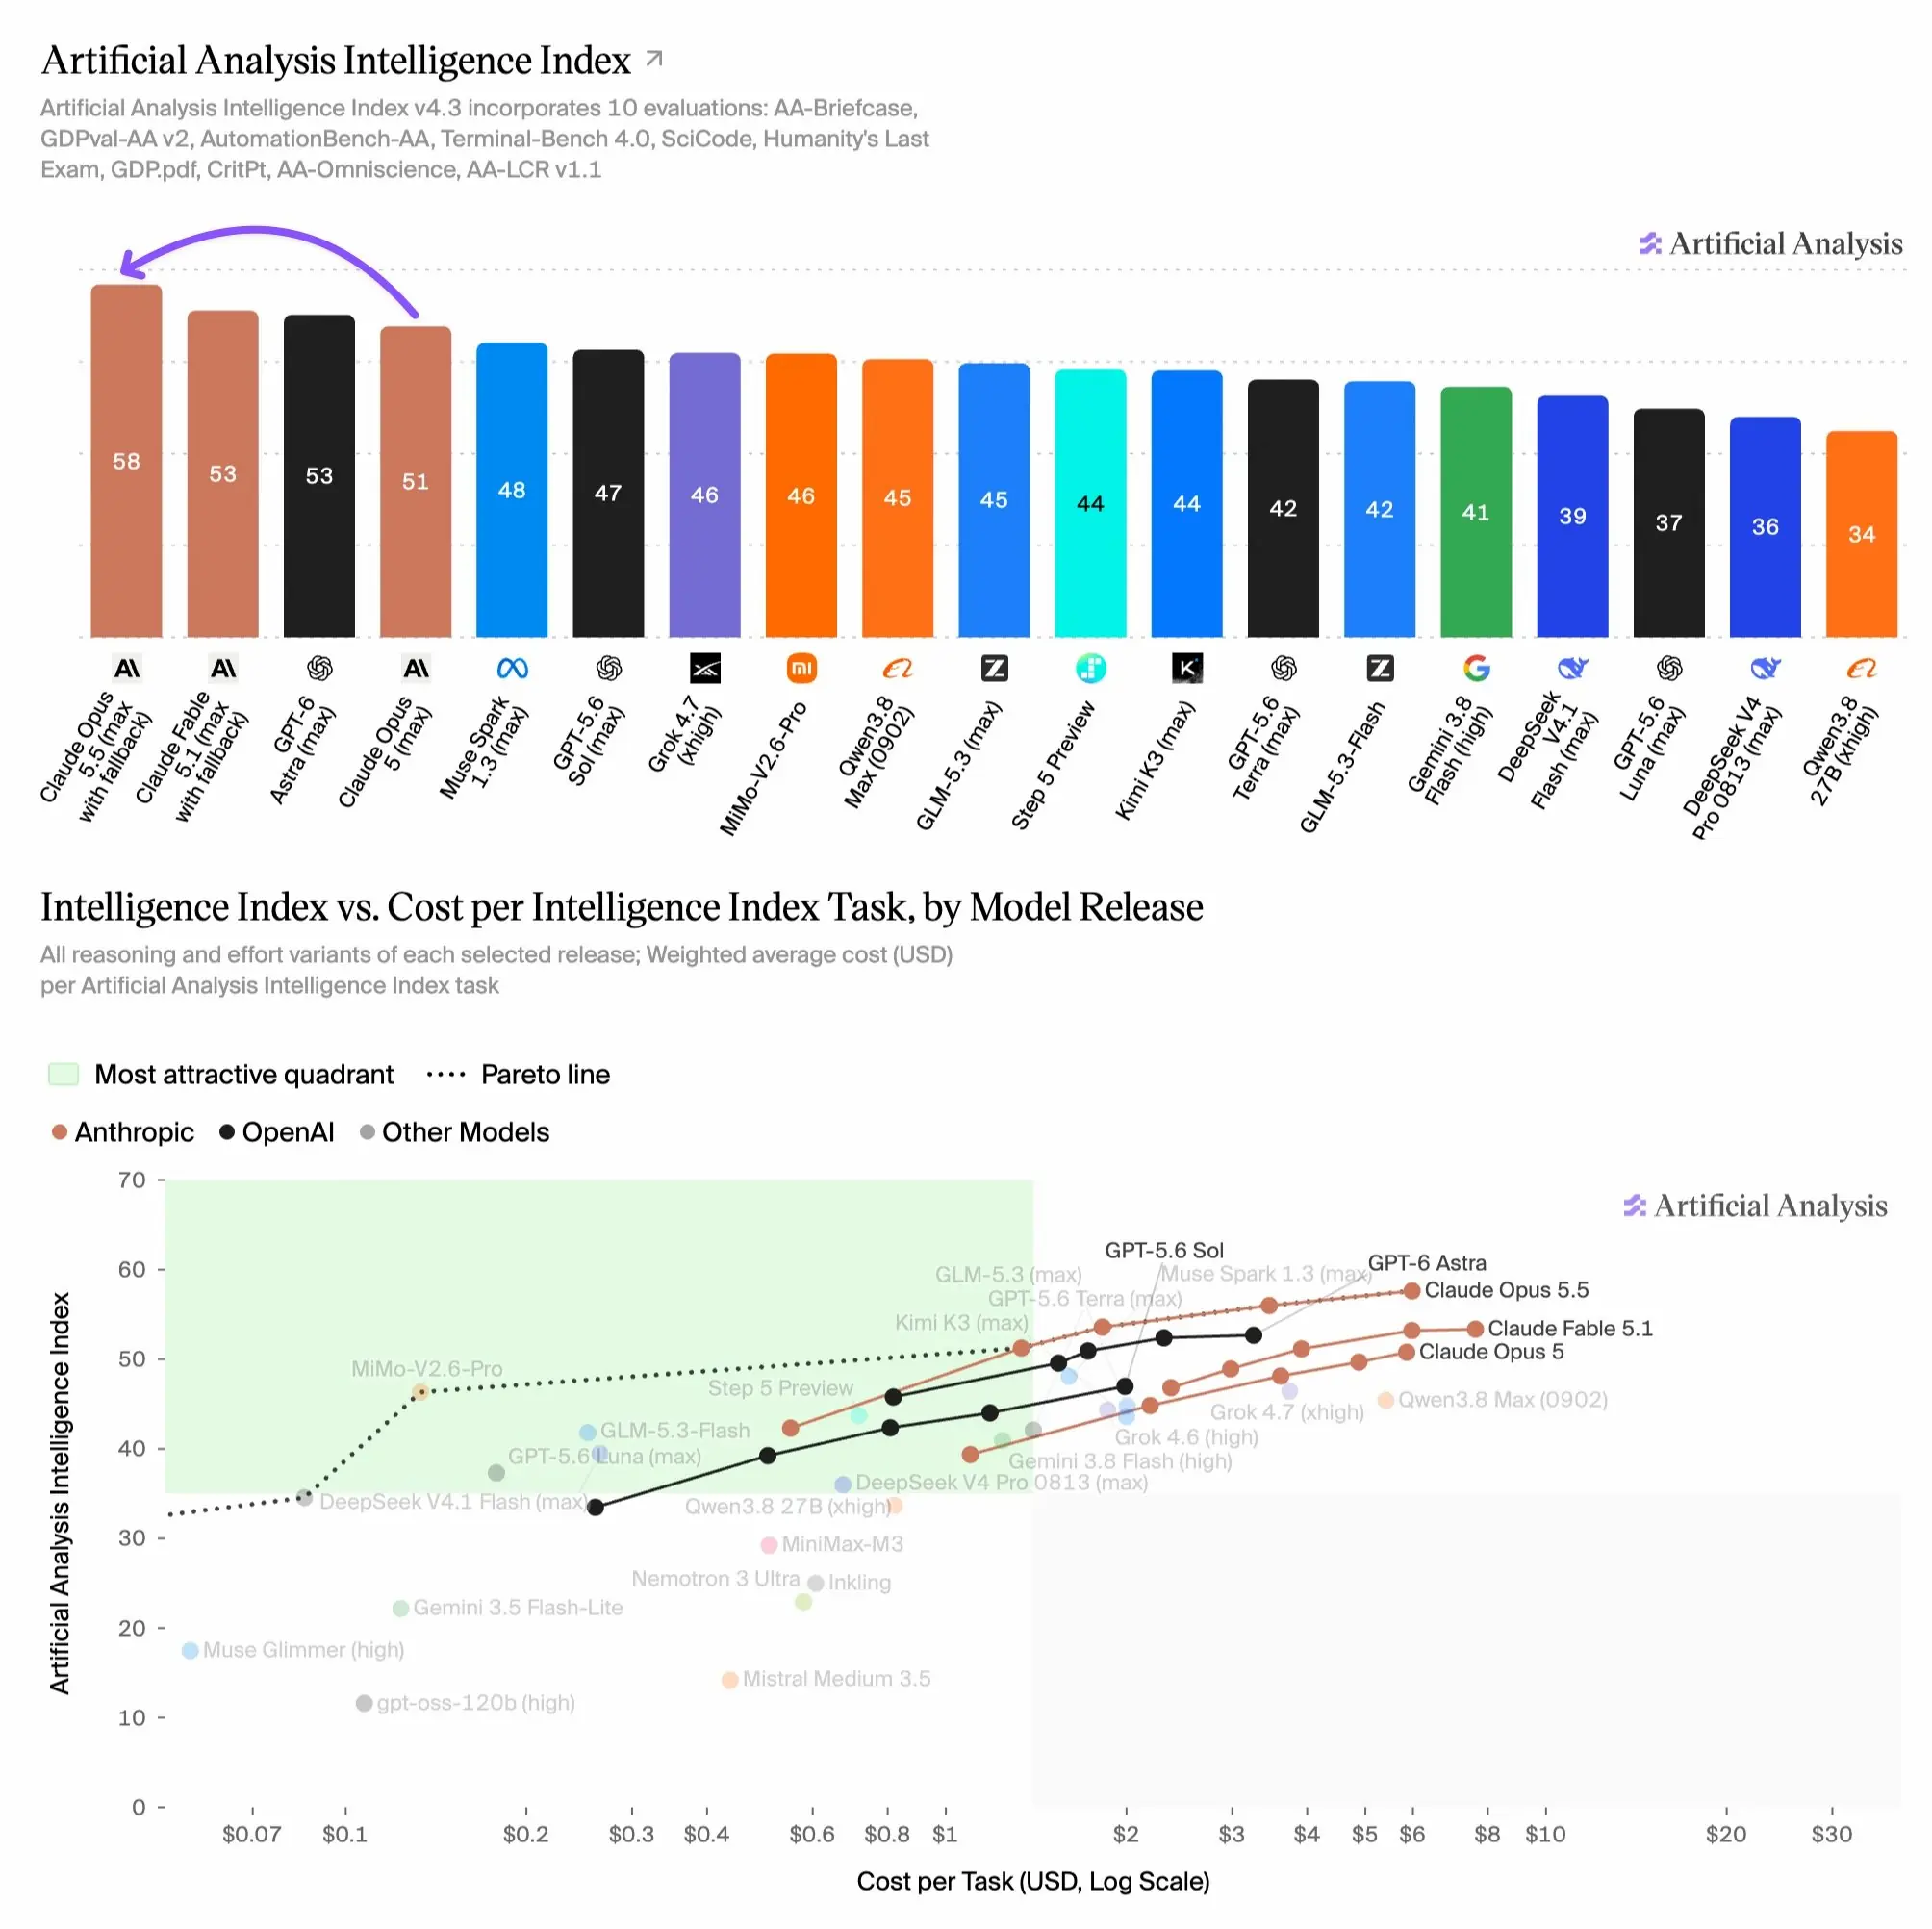
در FrontierCode، آنتروپیک میگوید Opus 5.5 با سطح تلاش پیشفرض، GPT-6 Astra را با حدود یکپنجم هزینه هر وظیفه پشت سر میگذارد. در Terminal-Bench 4.0 نیز با حدود ۴۰ درصد هزینه آسترا به عملکرد مشابه میرسد و در CursorBench با اختلاف ۱۱ امتیاز از GPT-5.6 Sol بالاتر قرار میگیرد. با این حال، Anthropic تأکید میکند فاصله بنچمارکی همیشه تفاوت واقعی مدلها را نشان نمیدهد.
آنتروپیک میگوید در استفاده داخلی، فاصله Opus 5.5 و Fable 5.1 کمتر از چیزی بوده که برخی امتیازهای بنچمارکی نشان میدهند. نتایج مدل، مگر در موارد خلاف آن، با Adaptive Thinking و بیشترین سطح تلاش محاسباتی به دست آمدهاند. در Terminal-Bench 4.0، Opus 5.5 با سطح xhigh و GPT-6 Astra با سطح high ارزیابی شدهاند و تدابیر ایمنی تولید نیز هنگام آزمون فعال بودهاند.
آزمون مهم Opus 5.5 با تدابیر ایمنی تولید فعال انجام شده است و هرجا این تدابیر مداخله کردهاند، وظایف امنیت سایبری به Opus 4.8 و وظایف زیستشناسی و توسعه مدلهای مرزی نیز به Opus 5 واگذار شدهاند؛ Anthropic میگوید این موضوع احتمالاً عملکرد ثبتشده Opus 5.5 را کاهش داده است و خطای استاندارد آن در Terminal-Bench 4.0 برابر ۲.۶ امتیاز بوده است.
برای دیگر مدلهای Claude در Terminal-Bench 4.0، خطای استاندارد بین ۱.۶ تا ۲ امتیاز بوده است. جدول عمومی با پنج اجرای هر وظیفه، Opus 5 را ۵۱.۸ درصد ثبت کرده و اجرای Anthropic به ۵۲.۳ درصد رسیده که در محدوده خطا قرار دارد. در AutomationBench، نتایج Opus 5.5 توسط Zapier و بدون مدل جایگزین به دست آمدهاند و مداخلات ایمنی شکست محسوب شدهاند.
بنچمارکها و رتبهبندی Claude Opus 5.5 در برابر رقبای مطرح:
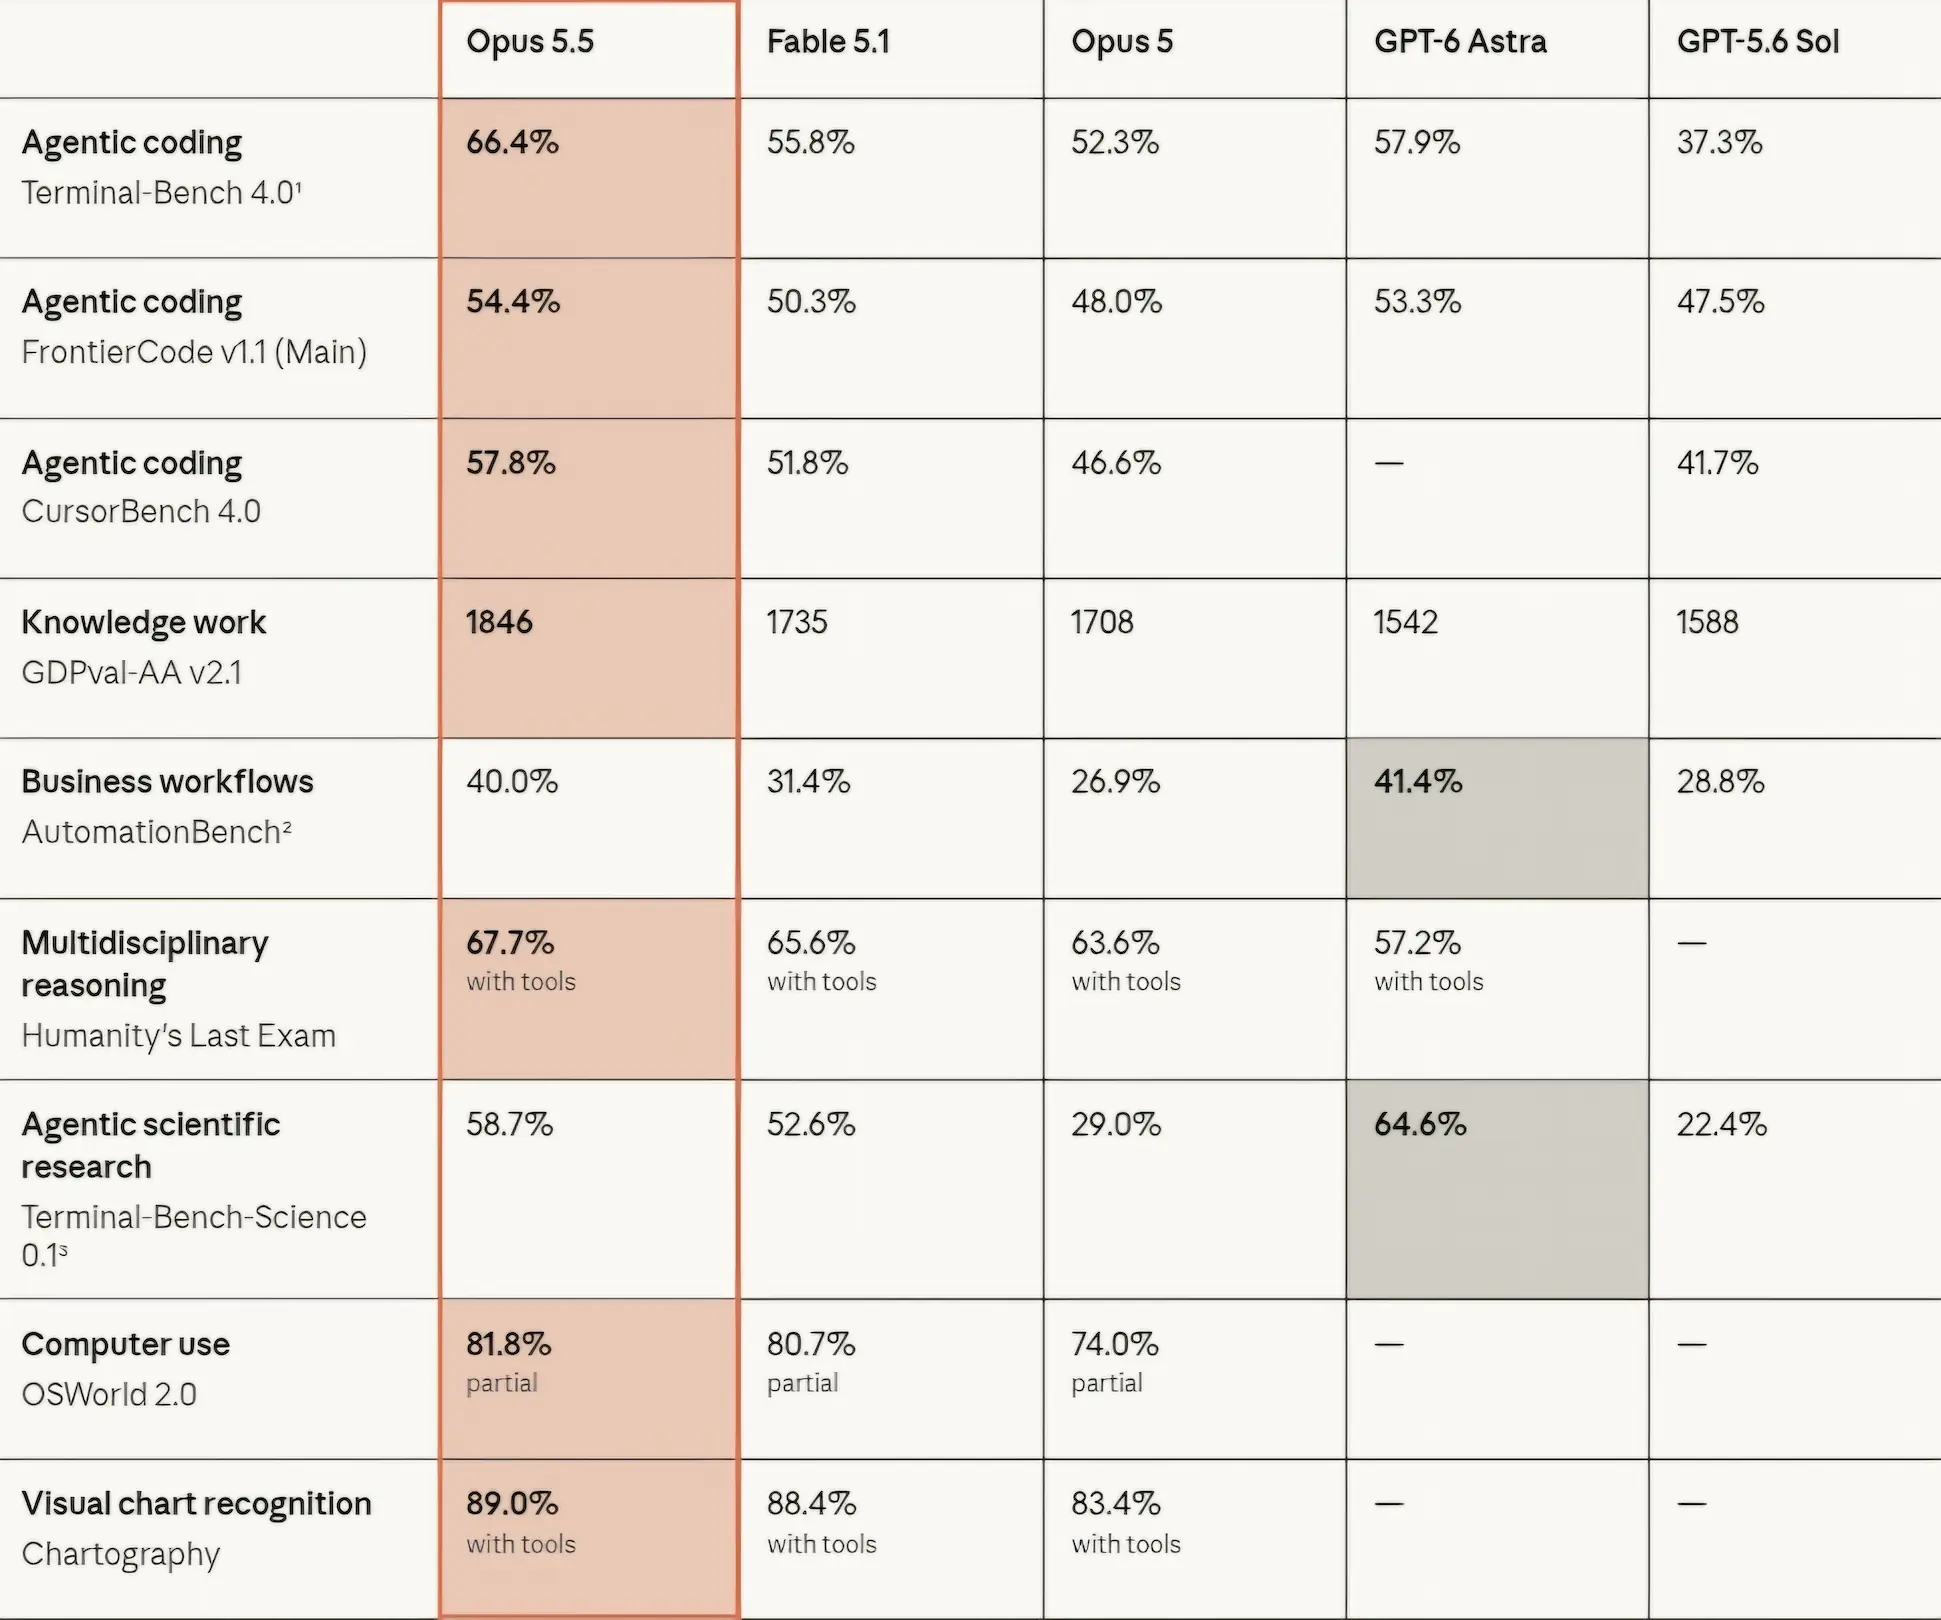
در Terminal-Bench-Science 0.1، خطای استاندارد مدلها بین ۳.۵ تا ۵ امتیاز بوده است. جدول عمومی Opus 5 را ۳۰ درصد ثبت کرده، در حالی که اجرای Anthropic به ۲۹ درصد رسیده است؛ عدد GPT-6 Astra از گزارش OpenAI گرفته شده. در یک ارزیابی پژوهشی، ۱۶ مورد از ۱۸ گزارش Opus 5.5 استاندارد کیفی را پشت سر گذاشتند، در حالی که هیچ تلاش Fable 5.1 یا Opus 5 به این معیار نرسید.
در آن ارزیابی، مدلها باید گزارش عملکرد فصلی یک شرکت را فقط با استفاده از نسخهای از وب تهیه میکردند که یافتن گزارش درآمدی در آن دشوار بود. ارزیاب خودکار همه ارقام و نقلقولها را با منابع تطبیق داد و وجود هر مورد ساختگی باعث ردشدن گزارش میشد. در تحلیل مالی نیز Walleye Capital گفت Opus 5.5 در پایینترین سطح تلاش تقریباً مجموعه ارزیابی آن را حل کرد.
Walleye Capital همچنین گزارش کرد که Opus 5.5 در سطوح بالاتر، خطایی را در دستورالعمل ارزیابی تشخیص داد و اصلاح کرد؛ طبق گزارش شرکت، هیچ مدل دیگری پیشتر آن را پیدا نکرده بود. در آزمایش ادغام فرضی دو شرکت نرمافزار منابع انسانی نیز هر دو مدل به نتیجه یکسانی رسیدند، اما مدل مالی Opus 5.5 کاملتر و ارائه آن خواناتر بود و هزینه تولید خروجی حدود ۵۰ درصد کمتر شد.
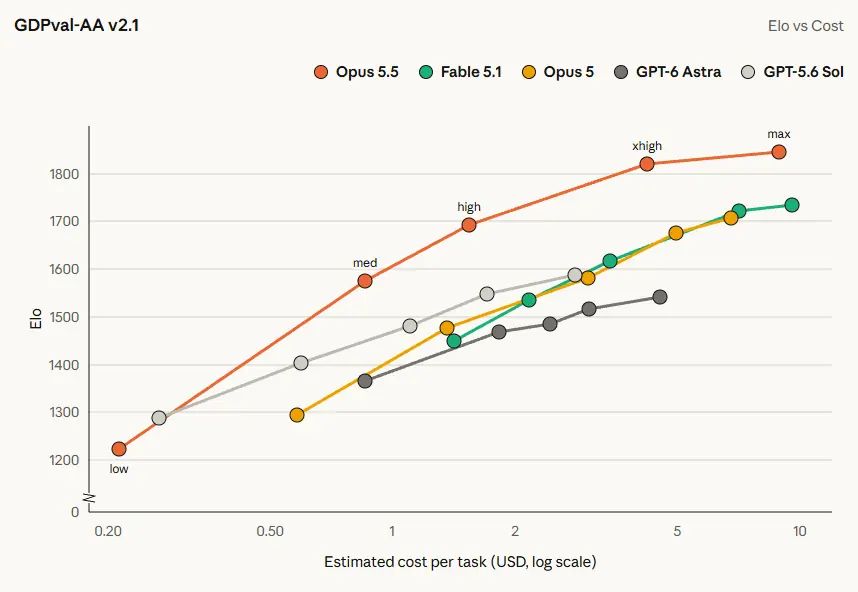
Opus 5.5 در همان آزمایش ادغام، کار را در ۶۳ دقیقه انجام داد و Opus 5 به ۹۳ دقیقه زمان نیاز داشت؛ در خروجی مدل قدیمی خطاهای جزئی نیز دیده شد. در GDPval-AA v2.1، آزمونی برای عملکرد واقعی در ۴۴ شغل، Opus 5.5 امتیاز ۱۸۴۶ Elo به دست آورده است. Anthropic همچنین میگوید در آزمونهای گردشکار تجاری و جمعآوری داده در مقیاس بزرگ، نتایج بهتری ثبت کرده است.
در سطح تلاش پیشفرض مدیوم، Anthropic میگوید Opus 5.5 در برابر GPT-6 Astra با بیشترین تلاش، عملکرد بالاتر و هزینهای حدود یکپنجم برای هر وظیفه داشته است. سبک ارتباطی مدل نیز تغییر کرده و نوشتهها واضحترند، اطلاعات مهم زودتر میآیند، اصطلاحات نامتعارف کمتر و پیروی از دستورهای نوشتاری بهتر است. این تغییرات بررسی خروجی در جلسات طولانی را سادهتر میکنند.
در بخش ایمنی، Opus 5.5 در برابر Prompt Injection در برنامهنویسی، استفاده از ابزارها، کار با رایانه و وبگردی با Opus 5 برابری کرده یا بهتر بوده است. در آزمون Gray Swan نیز همراه با Fable 5.1 کمترین نرخ موفقیت حملات را میان مدلها ثبت کرد. ارزیابی رفتاری Anthropic نزدیک به ۲ هزار سناریو را پوشش میدهد و مدل جدید در معیارهای رفتار ناسازگار بهتر از مدلهای اخیر Claude بوده است.
در ارزیابی عبور از مرزهای محصورسازی، Opus 5.5 حدود ۸۵ درصد کمتر از Opus 5 یا Claude Mythos 5.1 برای دورزدن محدودیتها تلاش کرد و همه تلاشها شدت پایینی داشتند و خود مدل آنها را گزارش کرد. با این حال، Anthropic میگوید آزمونهایی که بتوانند همه شکستهای احتمالی را پیش از عرضه شناسایی کنند هنوز وجود ندارند و Opus 5.5 گاهی متوجه ارزیابیشدن خود میشود.
اوپوس ۵.۵ در زیستشناسی از Opus 5 توانمندتر است و در بسیاری زمینهها با Claude Mythos 5.1 برابری یا بهتر عمل میکند. در ارزیابی طراحی مولکولی با Dyno Therapeutics بهبودهایی ثبت شد و ارزیابان متخصص نوآوری علمی آن را همسطح بهترین مدل آزمایششده دانستند. به همین دلیل، تدابیر زیستی Fable 5.1 برای آن اعمال شده و نهادها میتوانند برای Life Sciences Verification Program درخواست دهند.
وظایف تخصصی امنیت سایبری به Opus 4.8 ارجاع داده میشوند و Cyber Verification Program بهزودی Opus 5.5 را پوشش میدهد. Anthropic تدابیر ضد Distillation را فعال کرده است. قابلیت Preserved Thinking برای حسابهای API ایجادشده از ۳۱ اوت ۲۰۲۶ اعمال میشود و مانع ویرایش زمینه قبلی Claude برای استخراج استدلال خواهد شد. مدل با Zero Data Retention و Watermarking نیز ارائه میشود و با Thinking خاموش در دسترس نیست.
اوپوس ۵.۵ اکنون در Amazon Web Services، Google Cloud، Microsoft Azure و Claude Platform با شناسه claude-opus-5-5 در دسترس است. عرضه آن نخستین انتشار Anthropic پس از درخواست Dario Amodei برای Pace کردن پیشرفت مرزی هوش مصنوعی محسوب میشود. شرکت میگوید هدف این رویکرد، همگامکردن ایمنی با رشد توانایی مدلها، حفظ رقابت با چین و بهرهگیری از مزایای هوش مصنوعی، بهویژه در زیستشناسی و پزشکی است.
برای مدلهای فعلی، Anthropic به ارزیابی همترازی، آزمونهای پیش از عرضه توسط METR و Frontier Design و تدابیر ویژه در حوزههای پرخطر تکیه دارد. برای مدلهای آینده نیز فیلتر محیطهای Reinforcement Learning را سختگیرانهتر میکند، پاداشهای همترازی و سناریوهای آموزشی متنوع را بهبود میدهد و روی امنیت و نظارت مبتنی بر تفسیرپذیری کار میکند. این شرکت همچنین Responsible Scaling Policy را برای گزارش خطرهای مدلهای پیشرفته به کار میگیرد.
آنتروپیک معتقد است مدلهایی که بتوانند پژوهش هوش مصنوعی را کاملاً خودکار کنند، به استاندارد ایمنی بیشتری نیاز دارند و اقدامات فعلی برای این سطح کافی نیستند. این شرکت بر نقش بیشتر سیاستگذاری عمومی در ایمنی سیستمها تأکید کرده و زیرساخت همکاری با دولت آمریکا و صنعت برای تنظیمگری را توسعه میدهد. Claude Sonnet 5.5 و Claude Haiku 5.5 نیز هفتههای آینده عرضه میشوند و پیشرفتهای Opus 5.5 را دنبال میکنند.