آنتروپیک از Claude Sonnet 5.5 با جهش بزرگ در عملکرد و سرعت رونمایی کرد
آنتروپیک مدل Claude Sonnet 5.5 را معرفی کرده است؛ مدلی که نسبت به Sonnet 5 بیش از ۳۰ درصد سریعتر است و بهدلیل مصرف توکن کمتر، در بسیاری از وظایف تا ۳۰ درصد هزینه پایینتری دارد. این مدل دومین عضو خانواده Claude 5.5 محسوب میشود و برای کارهای روزمره، رفع باگ، تولید اسناد، ارائهها و فایلهای جدولی طراحی شده است، در حالی که Opus 5.5 برای کارهای پیچیدهتر باقی میماند.
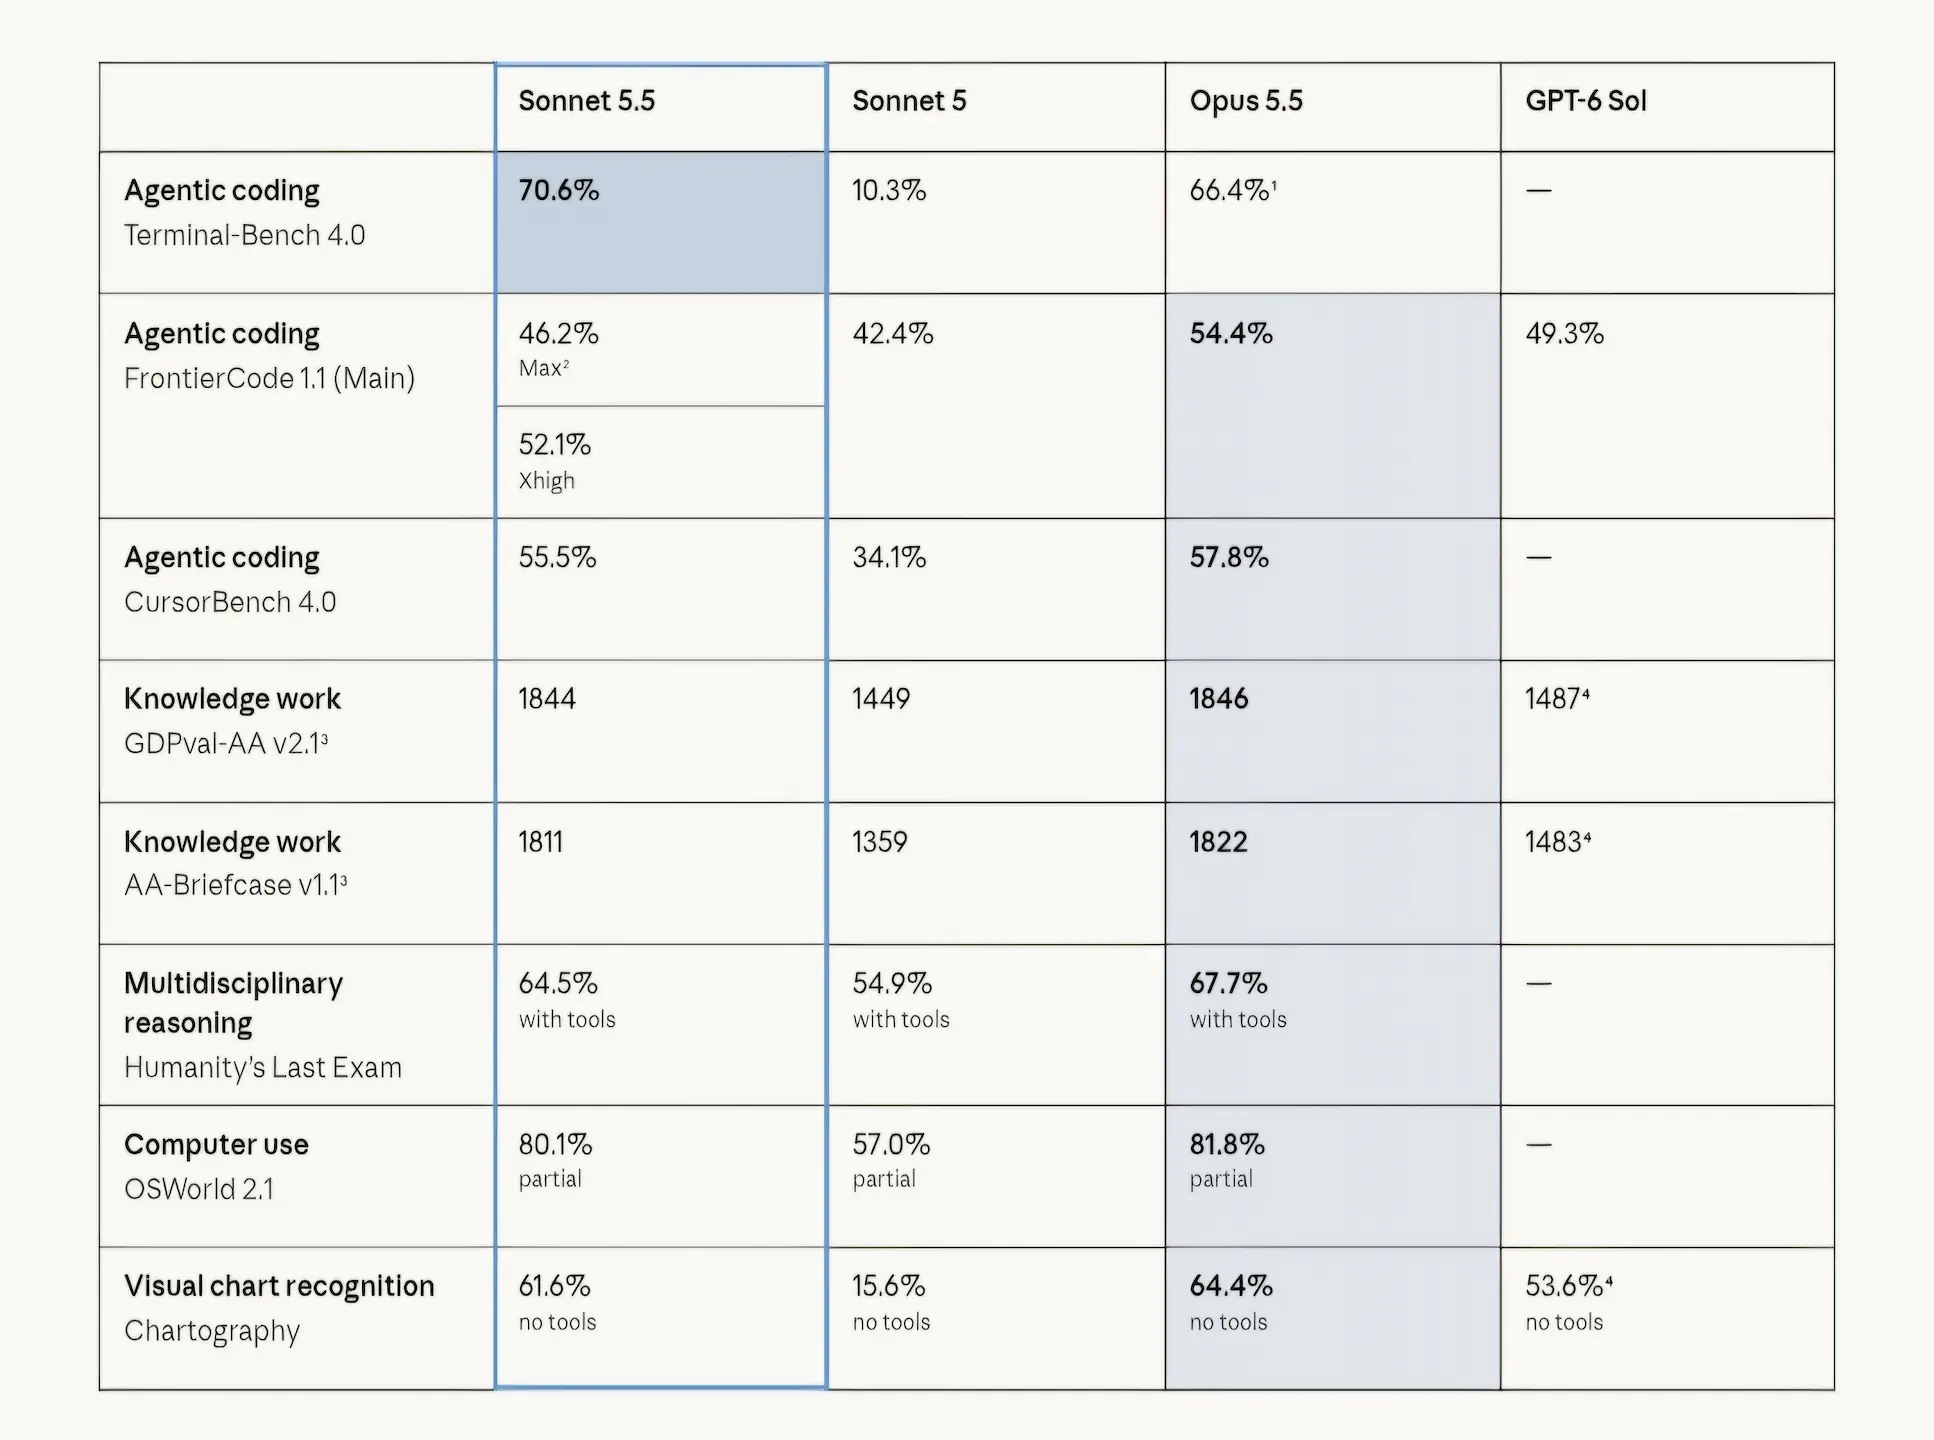
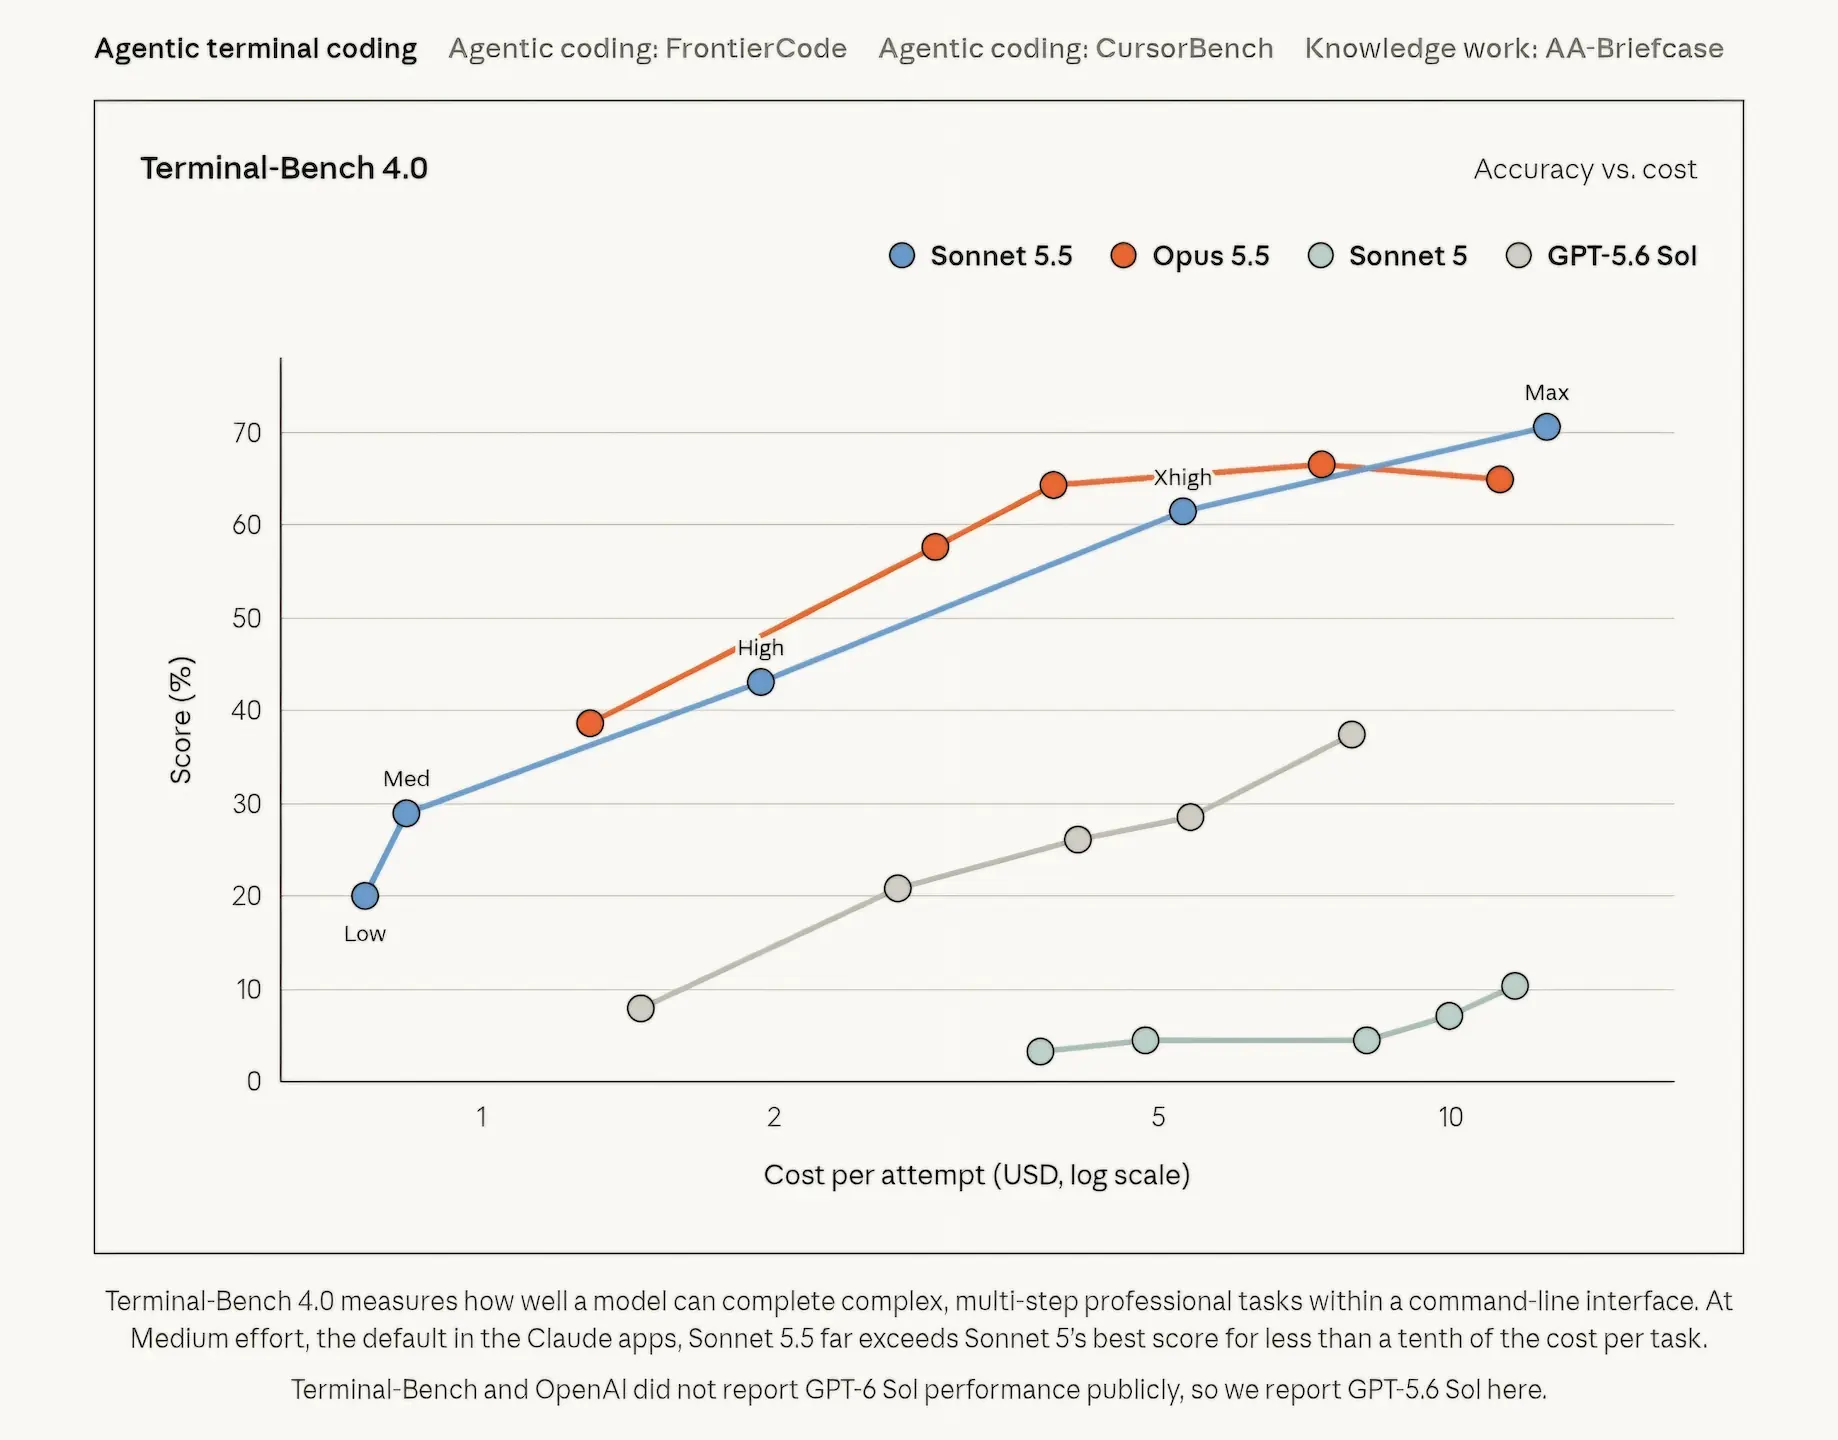
Sonnet 5.5 از نظر عملکرد جهش قابلتوجهی دارد و در ارزیابی کدنویسی عاملمحور Terminal-Bench 4.0 به امتیاز ۷۰.۶ درصد رسیده، در حالی که Sonnet 5 امتیاز ۱۰.۳ درصد داشته است. همچنین در آزمون GDPval-AA که توانایی انجام کارهای واقعی در مشاغل مختلف را میسنجد، تنها دو امتیاز با Opus 5.5 فاصله دارد. Anthropic میگوید Sonnet جدید در کارهای طولانیمدت و درک تصویر نیز قدرتمند است.
یکی از نشانههای پیشرفت این مدل، عملکرد آن در بازی Pokémon Red است؛ Sonnet 5.5 نخستین مدل Sonnet محسوب میشود که توانسته تنها با تکیه بر اسکرینشاتها از این آزمون عبور کند. در چند ارزیابی دیگر نیز نسخه Sonnet 5.5 با سطح تلاش Max به عملکردی نزدیک به Opus 5.5 رسیده است. با این حال، Anthropic تأکید میکند که امتیازهای بنچمارک فقط بخشی از توانایی مدل را نشان میدهند.
بررسیهای داخلی و آزمایشهای انجامشده توسط ارزیابان خارجی نشان میدهد Opus 5.5 همچنان در کارهای پیچیده و باز که به قضاوت مستمر نیاز دارند، بهوضوح قویتر است. Sonnet 5.5 بیشتر برای وظایف مشخص و روزمره ساخته شده و سرعت بالاتر آن امکان رفتوبرگشت سریعتر در فرایند کار را فراهم میکند. این مدل همچنین در زمینه طراحی توجه بیشتری به جزئیات بصری دارد و رابطهای کاربری و ارائهها را با پرداخت نهایی بهتری تولید میکند.
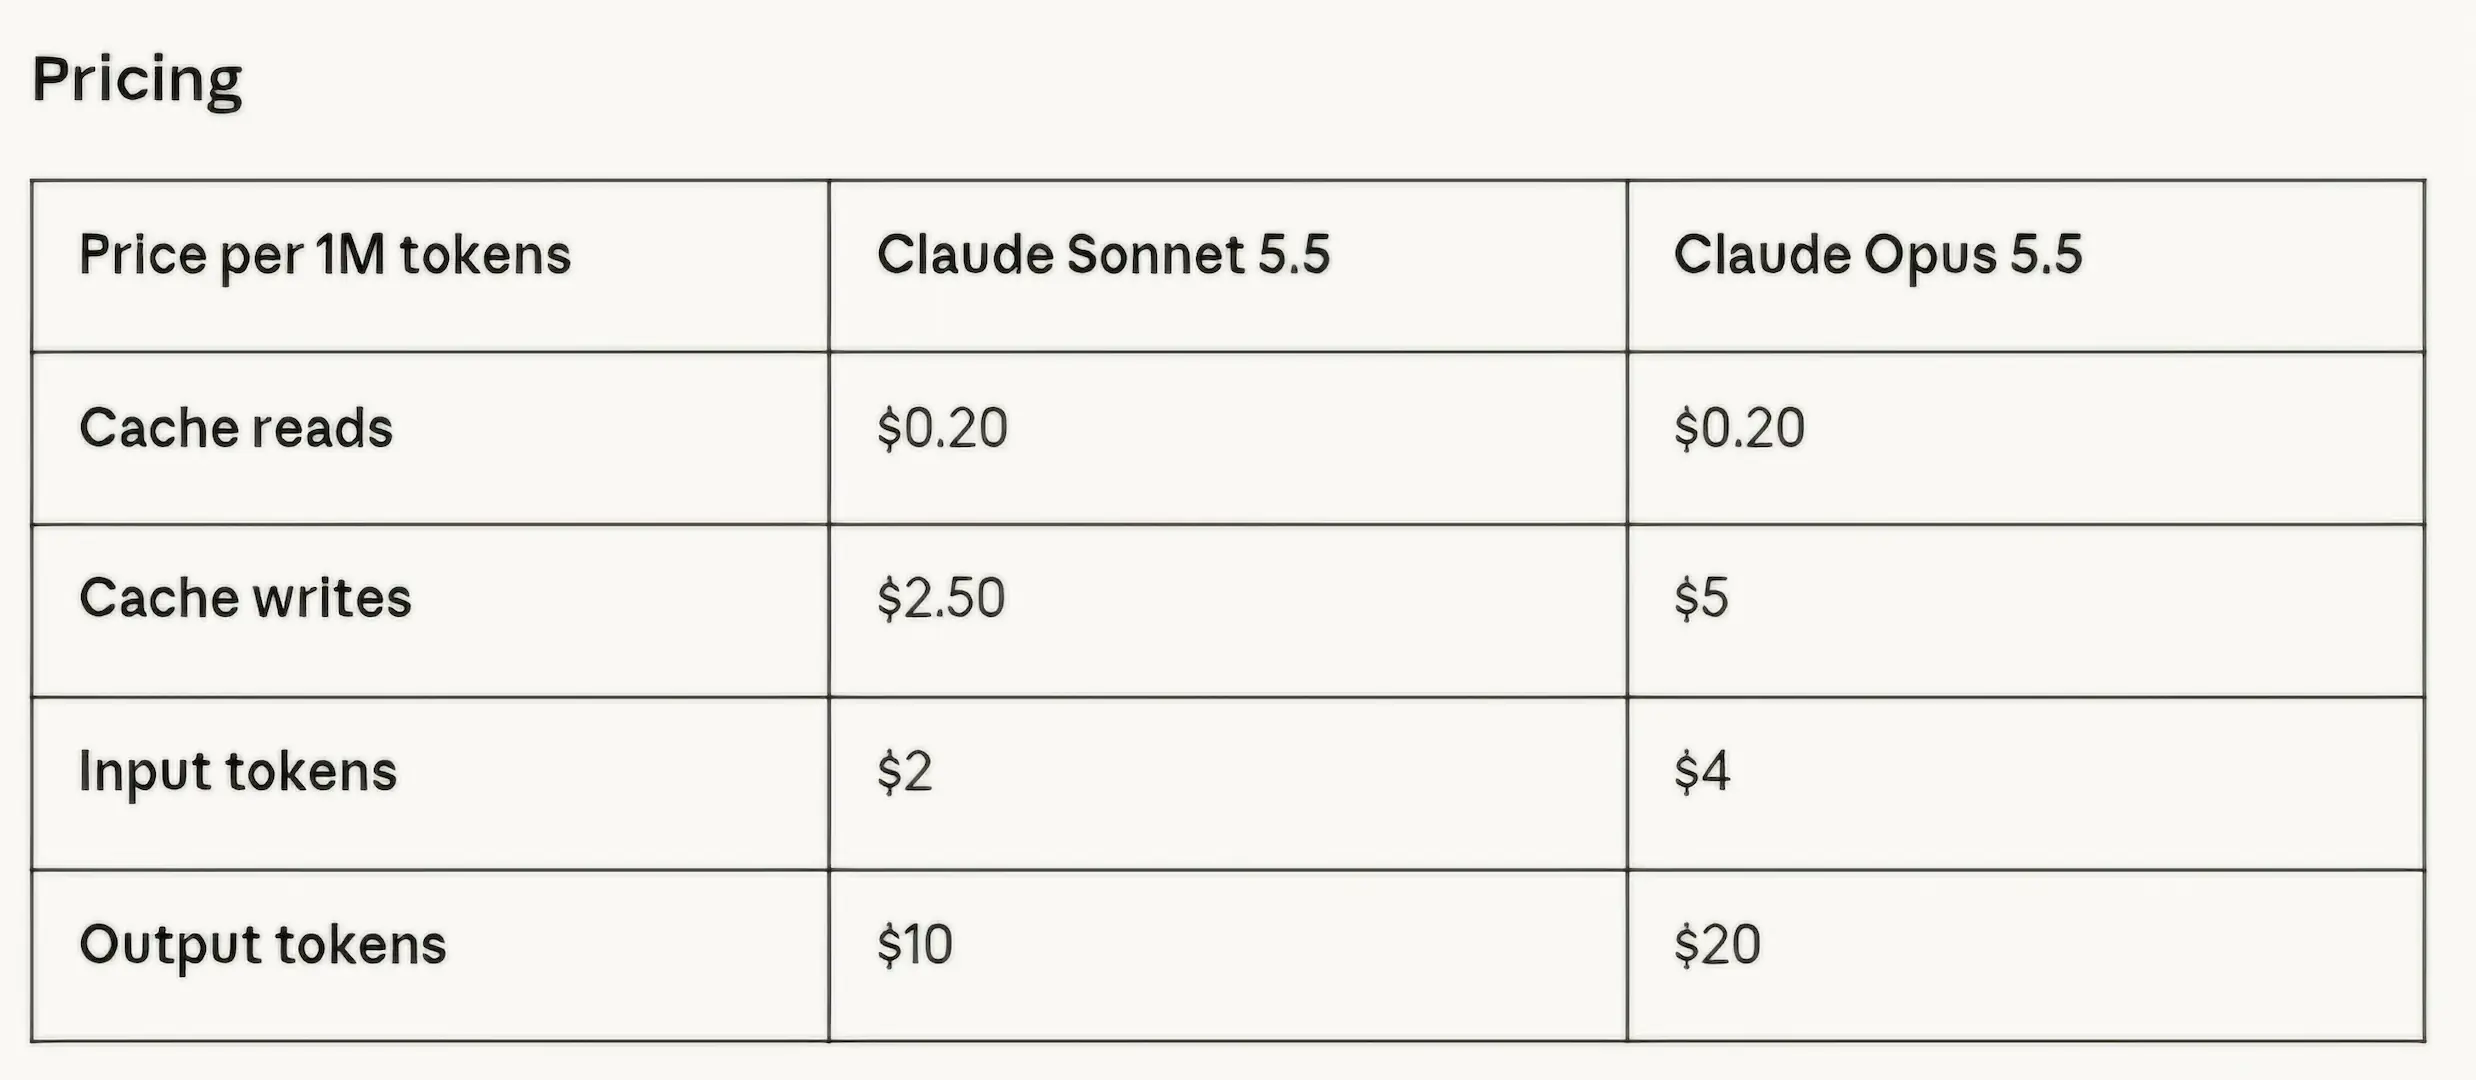
آنتروپیک قیمت اسمی Sonnet 5.5 را نسبت به نسل قبلی تغییر نداده است و هزینه این مدل برای هر یک میلیون توکن ورودی ۲ دلار، برای هر یک میلیون توکن خروجی ۱۰ دلار و برای هر یک میلیون توکن خواندن از حافظه کش ۲۰ سنت است. با این حال، Sonnet 5.5 برای انجام یک کار مشابه معمولاً توکنهای بسیار کمتری مصرف میکند و در آزمایشهای Anthropic هزینه هر وظیفه تا ۳۰ درصد کمتر شده است.
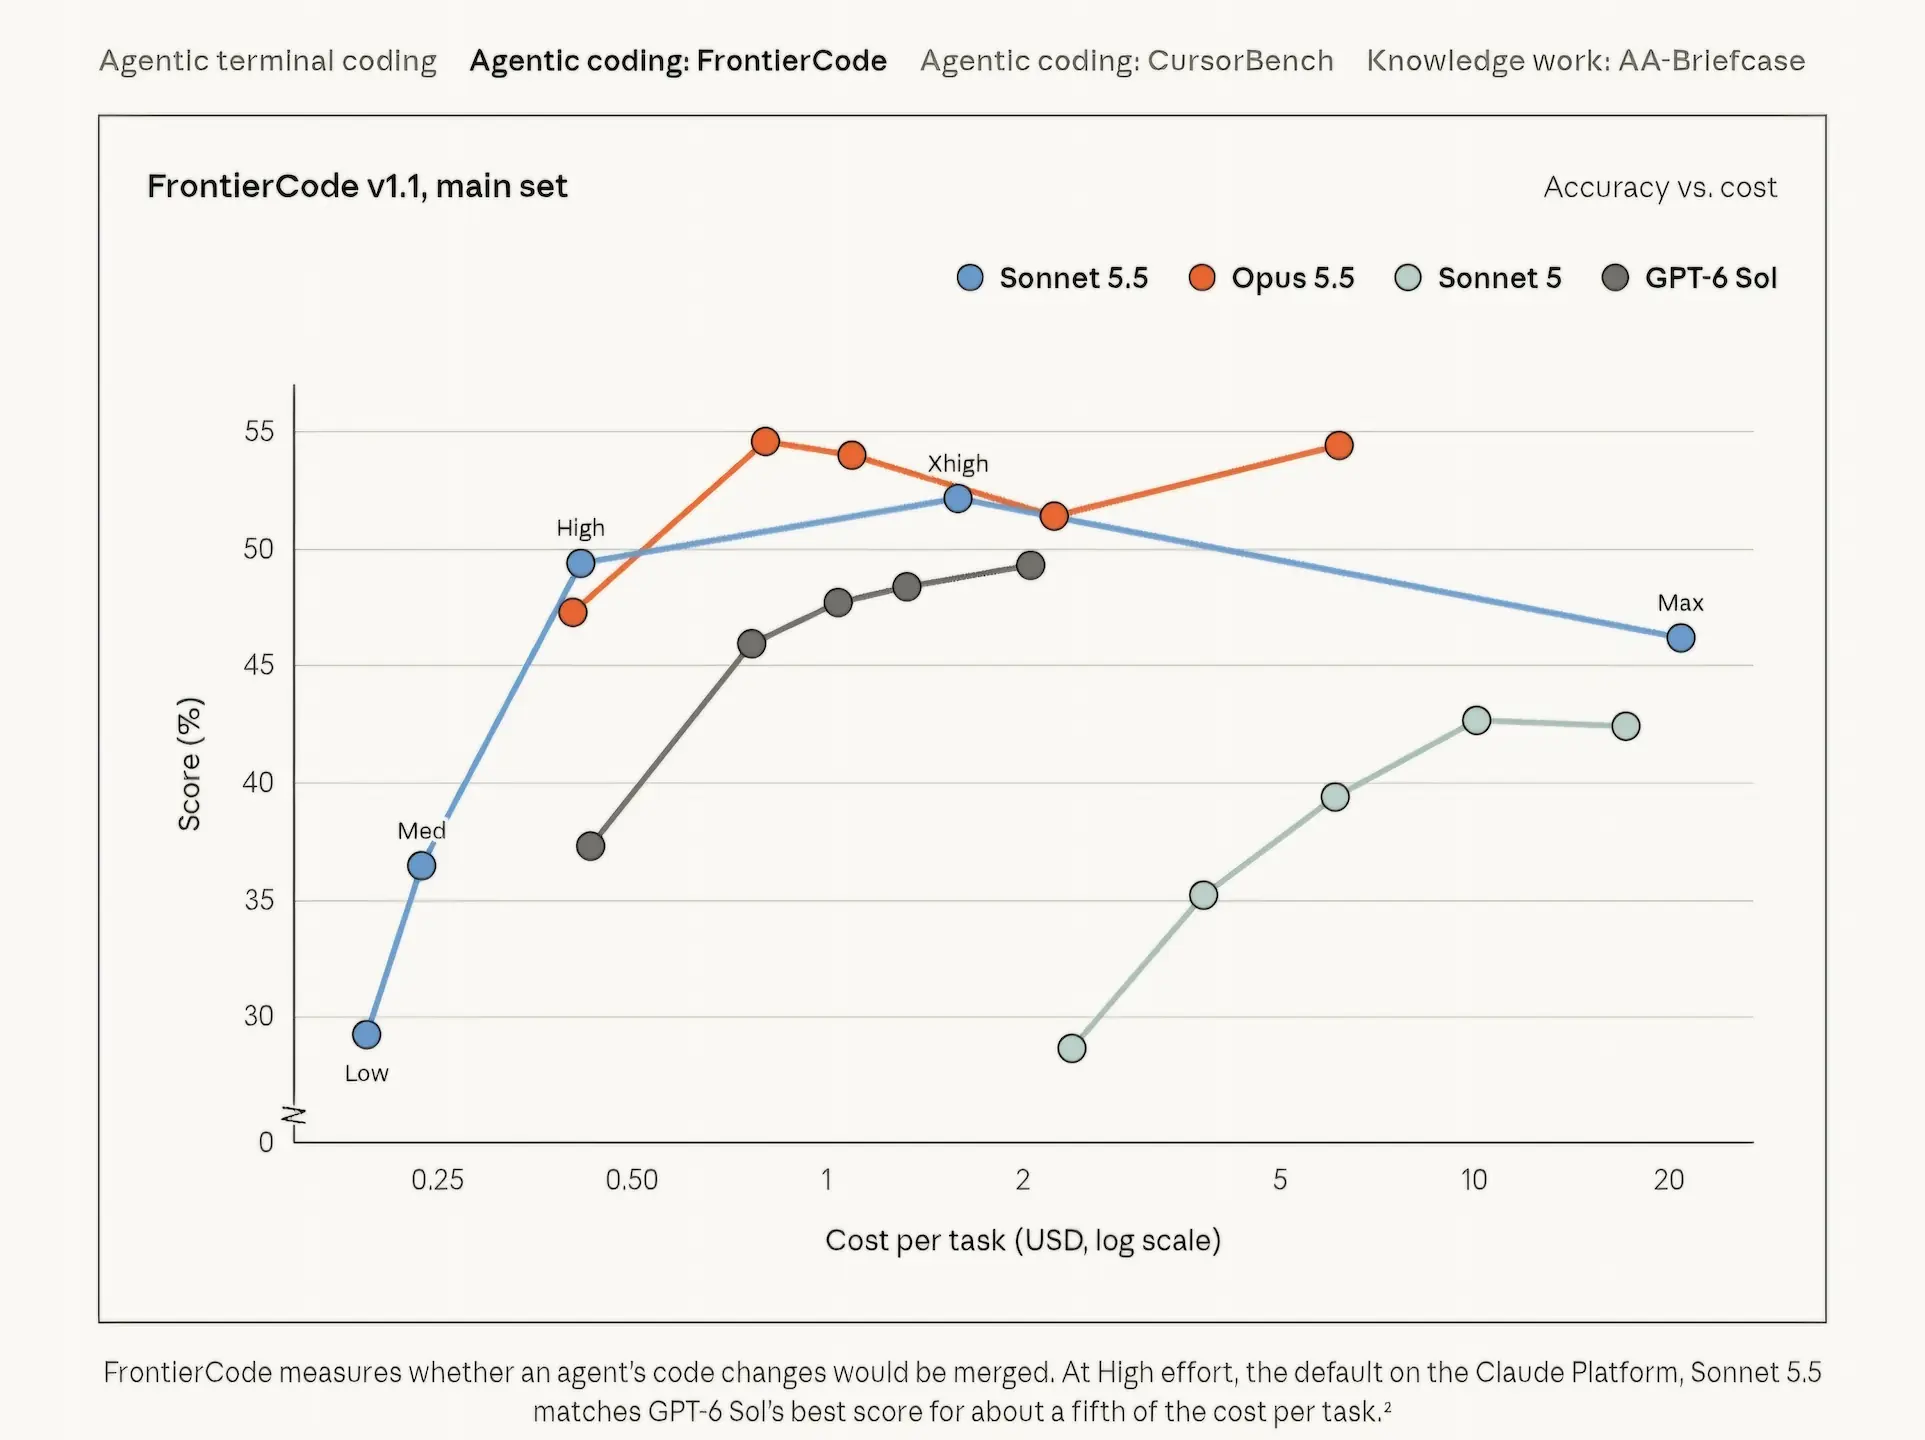
سرعت تولید خروجی نیز بیش از ۳۰ درصد افزایش یافته و Sonnet 5.5 را به سریعترین مدل Sonnet تا امروز تبدیل کرده است. کاربر میتواند با تغییر سطح تلاش، میان سرعت، هزینه و کیفیت تعادل برقرار کند. در Claude Code و برنامههای Claude، سطح پیشفرض تلاش Medium است، در حالی که Claude Platform بهصورت پیشفرض از High استفاده میکند. سطوح پایینتر پاسخ سریعتر و مصرف کمتر توکن دارند و سطوح بالاتر بررسی دقیقتری انجام میدهند.
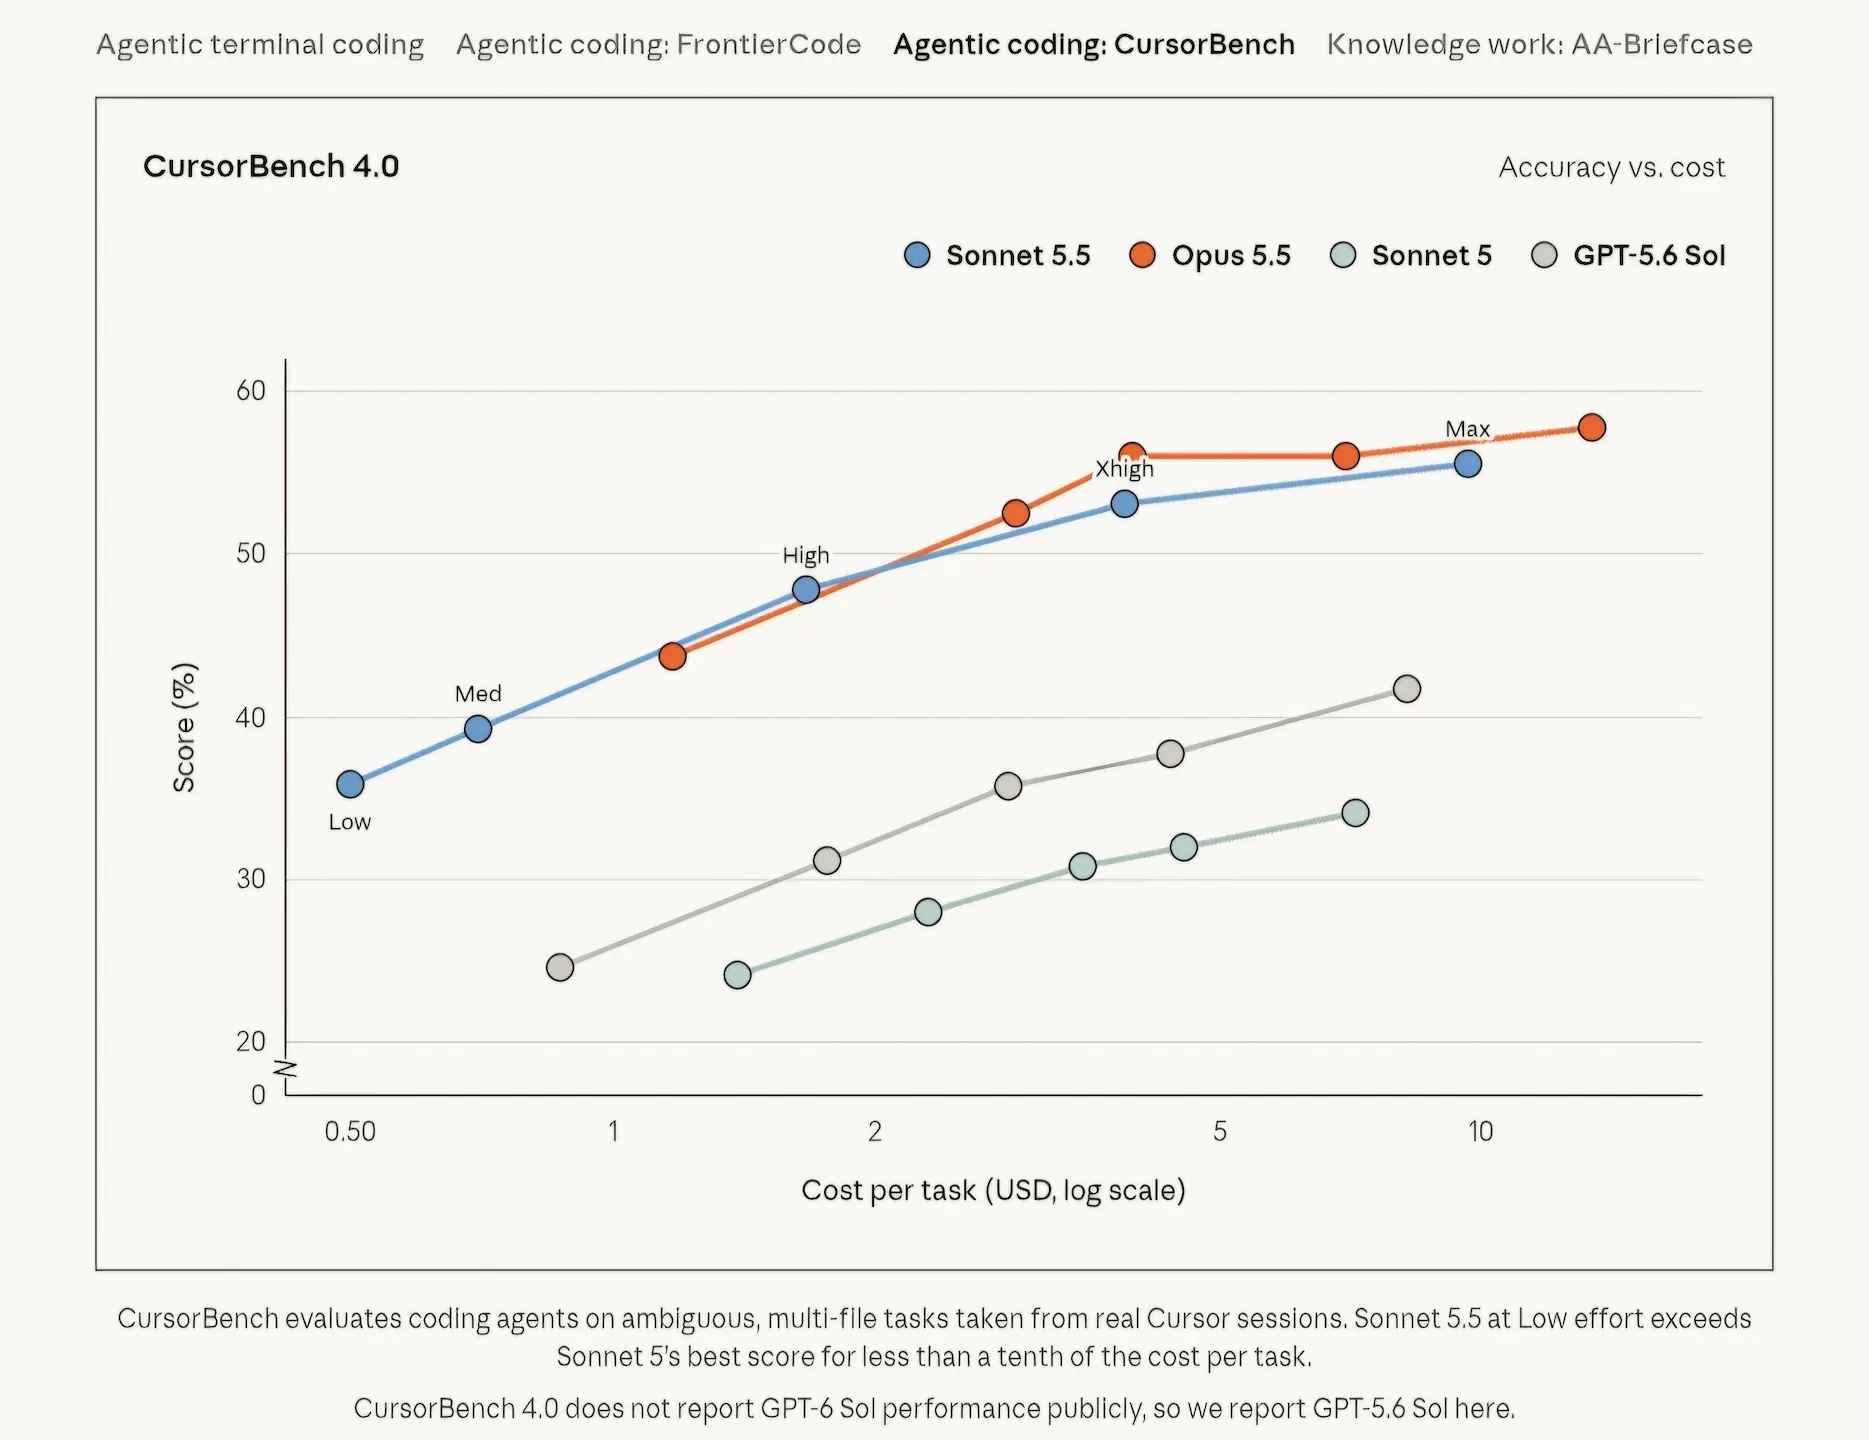
در حوزه برنامهنویسی، جهش عملکرد Sonnet 5.5 بیشتر به چشم میآید. این مدل در سطح تلاش High آزمون FrontierCode حدود ۱۰ امتیاز بالاتر از Sonnet 5 در همان سطح گرفته و هزینه هر وظیفه آن حدود یکپانزدهم بوده است. در CursorBench که وظایف برگرفته از نشستهای واقعی برنامهنویسی در Cursor را بررسی میکند، بهترین امتیاز Sonnet 5.5 تنها حدود دو امتیاز با Opus 5.5 فاصله دارد.
آزمایشکنندگان اولیه گفتهاند Sonnet 5.5 میتواند یک کدبیس را سریعتر درک کند و در اجرای ابزارها نیز کارآمدتر است. در مقایسه مستقیم، این مدل تماسهای ابزار را بیشتر بهصورت دستهای انجام داده و در نتیجه برای رسیدن به نتیجه به مراحل کمتری نیاز داشته است. این رفتار علاوه بر کوتاهتر کردن فرایند کار، هزینه اجرای وظایف را نیز کاهش میدهد و یکی از دلایل عملی پایینتر بودن هزینه کلی مدل است.
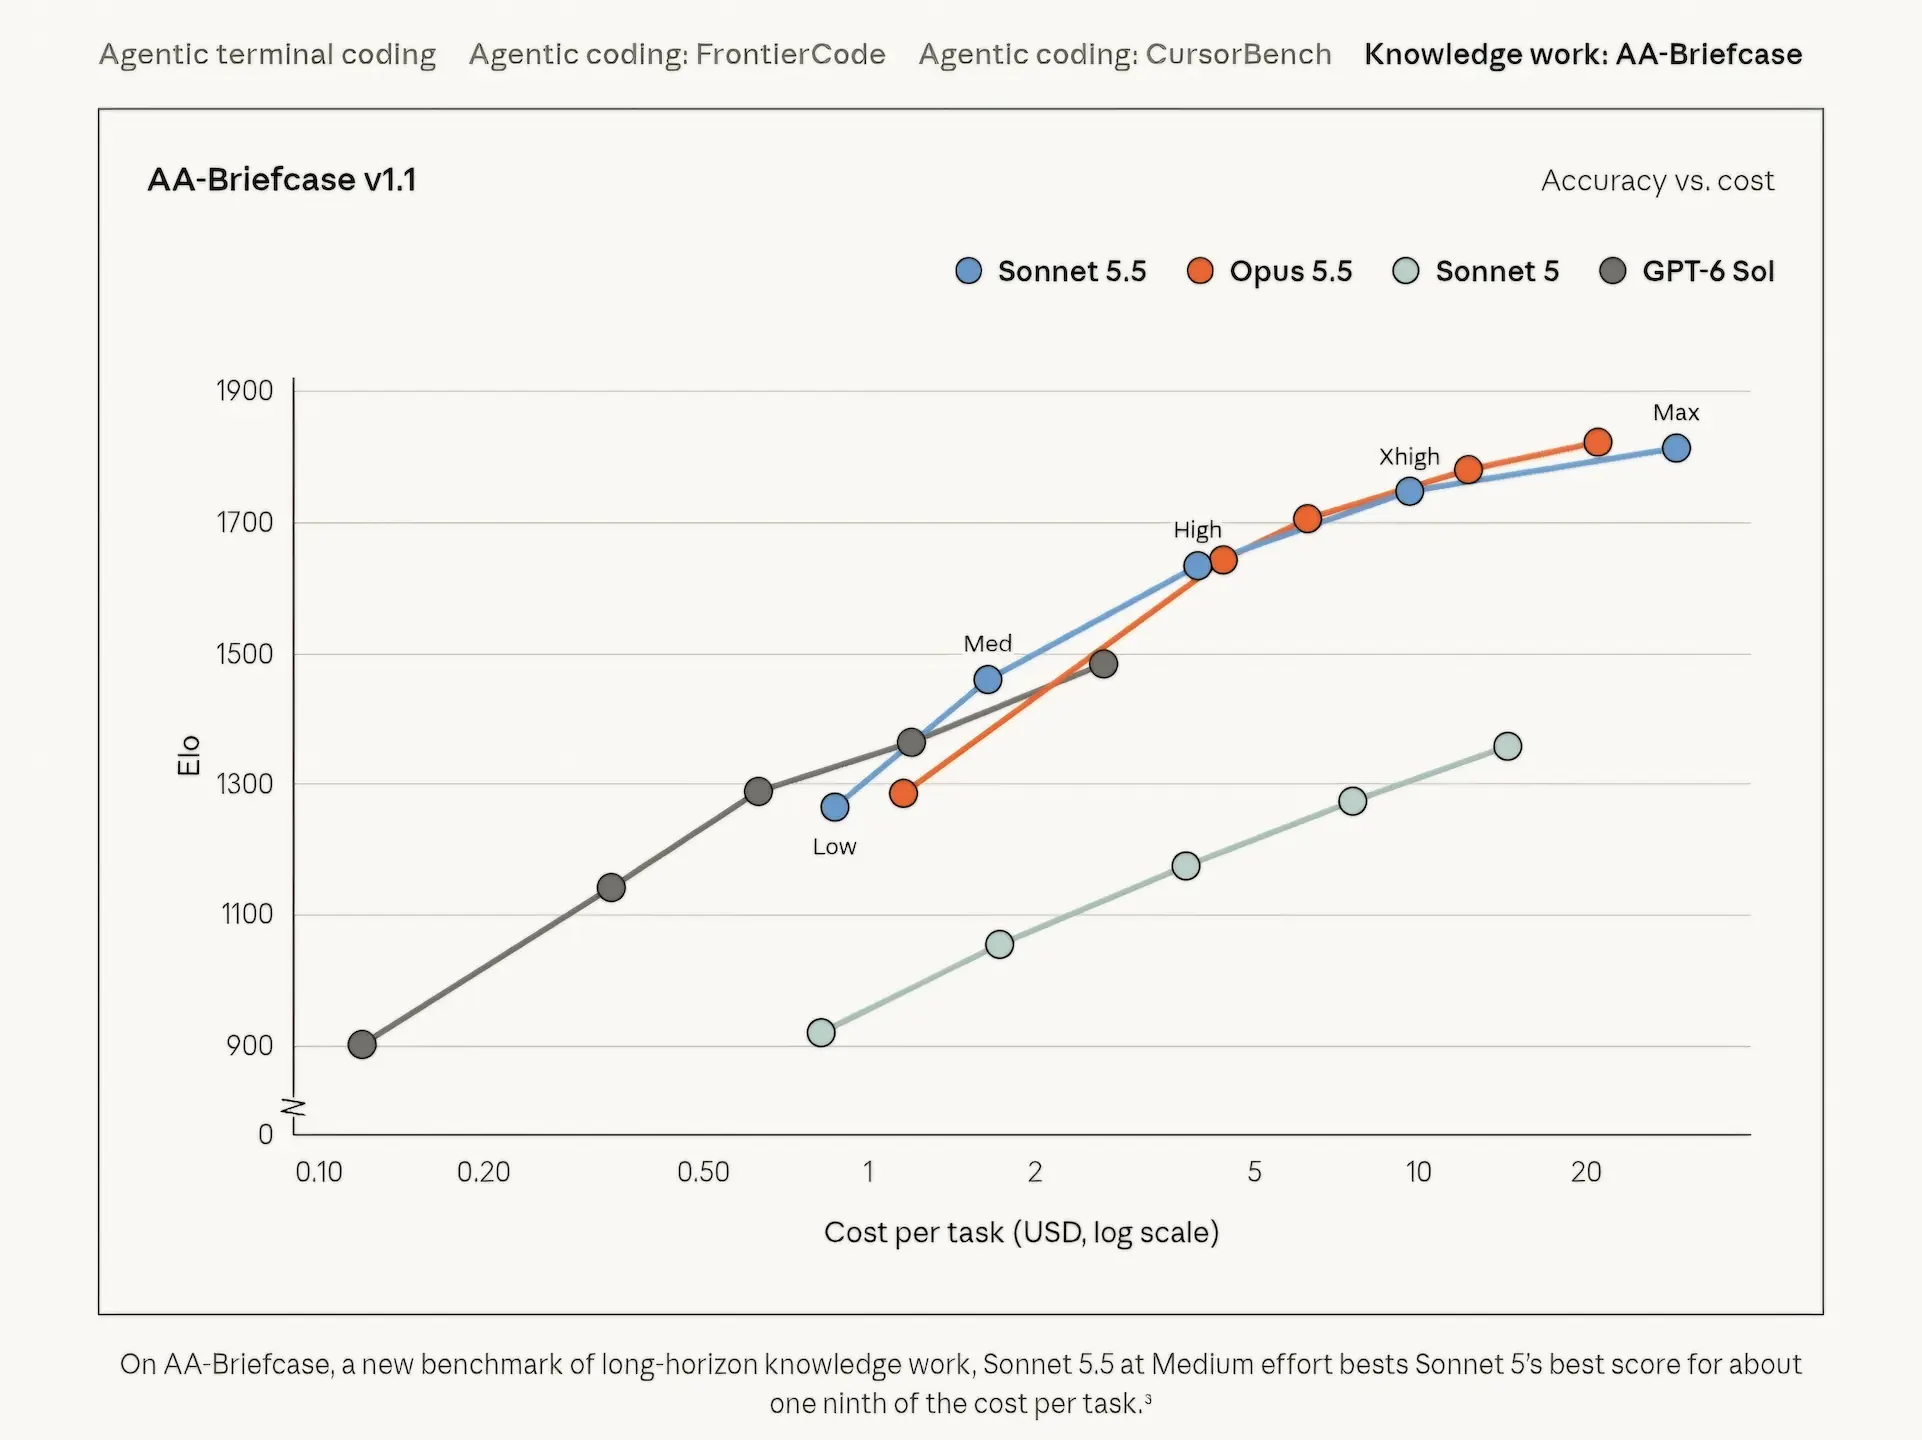
در حوزه دانش نیز Sonnet 5.5 پیشرفت کرده و در GDPval-AA، که وظایف واقعی مربوط به ۴۴ شغل در ۹ صنعت اصلی را ارزیابی میکند، این مدل تقریباً همسطح Opus 5.5 قرار گرفته و حدود ۴۰۰ امتیاز بالاتر از Sonnet 5 عمل کرده است. Sonnet 5.5 در استفاده از رایانه و تشخیص نمودار نیز به Opus 5.5 نزدیک است و در کارهای دانشمحور طولانیمدت نیز از Sonnet 5 و GPT-6 Sol بهتر عمل کرده است.
تسترهای اولیه علاوه بر امتیازهای عددی، تغییرات کیفی را نیز گزارش کردهاند. آنها Sonnet 5.5 را در گفتوگو طبیعیتر و برای همکاری مناسبتر دانستهاند و به توانایی آن در طراحی اشاره کردهاند. این مدل میتواند رابطهای کاربری را با پرداخت بیشتری تولید کند و قالب اسلایدها را دنبال کند تا ارائههایی بسازد که به ویرایش کمی نیاز داشته باشند. در یک آزمایش داخلی، نخستین پیشنویس یک ارائه ۱۰ اسلایدی آماده ارسال ارزیابی شد.
در آن آزمایش، به مدل گزارشهای مالی فصلی و متن تماسهای درآمدی یک شرکت سهامی عام، بههمراه قالب مشخص اسلاید، داده شد و از آن خواسته شد یک مرور عملیاتی ۱۰ اسلایدی آماده کند. دو متخصص خروجی نخست را بدون نیاز به ویرایش بیشتر، آماده ارسال دانستند. Anthropic این نتیجه را در کنار بهبودهای کمی مدل مطرح میکند، اما همزمان تأکید دارد که ارزیابیهای بنچمارکی بهتنهایی نماینده تمام قابلیتهای یک مدل نیستند.
کاهش مصرف توکن در Sonnet 5.5 بهطور مستقیم روی هزینه اجرای وظایف اثر میگذارد. در تنظیمات تلاش پایین یا متوسط، این مدل در چند بنچمارک توانسته بهترین امتیاز Sonnet 5 را با حدود یکدهم هزینه هر وظیفه پشت سر بگذارد. از طرف دیگر، در سطحهای بالاتر تلاش، عملکرد آن میتواند با Opus 5.5 قابلمقایسه باشد و هزینهای مشابه داشته باشد. بنابراین انتخاب سطح تلاش، بخش مهمی از کنترل هزینه و کیفیت خواهد بود.
بنچمارکهای رسمی Claude Sonnet 5.5 و مقایسه با چند مدل دیگر:
آنتروپیک برای Sonnet 5.5 ارزیابی ایمنی و همراستایی گستردهای انجام داده و این ارزیابی حدود ۱۸۵۰ سناریو را پوشش میدهد و رفتار مدل در زمینههایی مانند اقدام برخلاف منافع کاربر، گمراهکردن کاربران و همکاری در سوءاستفادههای پرخطر را بررسی میکند. Sonnet 5.5 در بیشتر معیارهای همراستایی، مقاومت در برابر سوءاستفاده و صداقت، نسبت به Sonnet 5 بهتر یا همسطح بوده است.
در ارزیابیهای جدید مربوط به مهارپذیری نیز Sonnet 5.5 به Opus 5.5 نزدیک شده است. این مدل در میان مدلهای آزمایششده کمترین تمایل را برای بررسی مرزهای محیطهای محصور و از جمله کمترین تمایل به تلاش برای خروج از سندباکس نشان داده است. در مجموع، Opus 5.5 همچنان عملکرد اندکی بهتر در ارزیابی کامل داشته، اما Anthropic میگوید شواهدی پیدا نکرد که Sonnet 5.5 اهدافی برخلاف خواسته کاربر دنبال کند.
با وجود این نتایج، Anthropic هشدار میدهد هیچ مجموعه ارزیابیای نمیتواند همه شکستهای احتمالی را شناسایی کند و ممکن است گرایشهایی در Sonnet 5.5 وجود داشته باشد که هنوز کشف نشدهاند. به همین دلیل، این شرکت ارزیابیهای داخلی خود را با سازوکارهای ایمنی تکمیل کرده است. این رویکرد بخشی از چارچوب ارزیابی همراستایی Anthropic است و صرفاً به نتایج آزمونهای رفتاری محدود نمیشود.
قابلیتهای امنیت سایبری Sonnet 5.5 نسبت به Sonnet 5 بهطور چشمگیری افزایش یافته و به همین دلیل Anthropic برای آن سازوکارهای حفاظتی مشابه Opus 5.5 در نظر گرفته است. کاربران همچنان میتوانند برای توسعه عادی نرمافزار، باگهای کد خود را پیدا و اصلاح کنند، اما وظایف امنیت سایبری پرخطر بهصورت قابل مشاهده به Sonnet 5 منتقل خواهند شد. این شرکت همچنین برنامه Cyber Verification Program را برای دسترسی سطحبندیشده به قابلیتهای پیشرفتهتر گسترش میدهد.
در حوزه زیستشناسی، Sonnet 5.5 همان مجموعه حفاظتی Sonnet 5 را حفظ کرده است. این محدودیتها درخواستهای آسیبزا را هدف میگیرند و طبق توضیح Anthropic، بیشتر فعالیتهای پژوهشی، آموزشی و بالینی را تحت تأثیر قرار نمیدهند؛ با این حال برخی درخواستهای مربوط به میکروبیولوژی و ویروسشناسی ممکن است اشتباهاً علامتگذاری شوند. سازمانها میتوانند برای دسترسی به سازوکارهای مناسبتر برای طیف کامل فعالیتهای زیستشناسی، در Life Sciences Verification Program درخواست دهند.
آنتروپیک همچنین برای مقابله با حملات تقطیر، یعنی استفاده از هزاران حساب جعلی برای استخراج قابلیتهای مدل در مقیاس صنعتی، حفاظت جدیدی اضافه کرده است. Sonnet 5.5 نخستین مدل Sonnet است که با طبقهبندیکنندههای ایمنی جلوگیریکننده از استخراج فرایند استدلال عرضه میشود. این مدل همچنین قابلیت preserved thinking را گسترش میدهد تا فرایند فکرکردن Claude از حسابی که آن را ایجاد کرده جدا نشود؛ بیشتر توسعهدهندگان تغییر محسوسی نخواهند دید.
در نتیجه این تغییر، جابهجایی مکالمه میان حسابها، از جمله تغییر حساب در میانه یک نشست Claude Code، مشمول محدودیتهای جدید خواهد بود و Anthropic برای آن راهنمای مهاجرت ارائه کرده است. Sonnet 5.5 مانند Opus 5.5 و Sonnet 5 با گزینه نگهداری صفر داده در دسترس است. این مدل اکنون روی تمام پلتفرمهای ارائهشده توسط Anthropic، از جمله Amazon Web Services، Google Cloud و Microsoft Azure، قابل استفاده است.
توسعهدهندگان میتوانند Sonnet 5.5 را در Claude Platform با شناسه claude-sonnet-5-5 استفاده کنند. در صورتی که Sonnet با قابلیت thinking خاموش اجرا شود، برای مهاجرت به نسخه جدید باید به تنظیم between_tools منتقل شوند؛ این تنظیم تفکر اولیه را خاموش نگه میدارد. Anthropic در راهنمای مهاجرت خود جزئیات تغییرات مربوط به این حالت را توضیح داده است. Haiku 5.5 نیز بهعنوان عضو بعدی خانواده Claude 5.5 در هفتههای آینده عرضه خواهد شد.