اوپنایآی از GPT-6 Sol و Luna با نصف قیمت رونمایی کرد؛ البته با پیشرفت ضعیف!
اوپنایآی با معرفی GPT-6 Sol و GPT-6 Luna، مدلهای تازه خود را با تمرکز بر کاهش هزینه عرضه کرده است؛ هر دو مدل در مقایسه با نسل قبلی تقریباً همان عملکرد را هدف گرفتهاند، اما قیمت توکن آنها نصف شده است. Sol برای کارهای پیچیده مانند توسعه قابلیت، بازبینی و رفع خطای کد و تحلیل داده طراحی شده و Luna برای کارهای مشخص، مانند خلاصهسازی و استخراج اطلاعات، کاربرد دارد.
قیمت GPT-6 Sol برای هر یک میلیون توکن ورودی از ۴ دلار به ۲ دلار و برای خروجی از ۲۰ دلار به ۱۰ دلار کاهش یافته است. هزینه ورودی GPT-6 Luna نیز از ۰.۲ دلار به ۰.۱ دلار و خروجی از ۱.۲ دلار به ۰.۵ دلار رسیده است. شرکت این کاهش را نتیجه بهبود کش و استنتاج میداند و میگوید این صرفهجویی را به کاربران منتقل کرده است.
اوپنایآی سیستم کش پرامپت GPT-6 را نیز بهبود داده و برای توکنهای ورودی ذخیرهشده، ۹۰ درصد تخفیف در نظر گرفته است. داشبورد تازه پایش کش و ابزارهای تشخیصی نیز به توسعهدهندگان کمک میکنند استفاده از کش را بهینه کنند. همچنین تغییر سطح استدلال یا ابزارهای در دسترس مدل دیگر باعث بیاعتبار شدن کش نمیشود؛ قابلیتی که برای جریانهای کاری تکرارشونده اهمیت دارد.
هر دو مدل هنگام عرضه از طریق ChatGPT Work و Codex برای مشترکان پلاس، پرو، Business، Enterprise و Edu در دسترس هستند و دسترسی در ChatGPT بهتدریج گسترش مییابد. کاربران Free و Go میتوانند Luna را از اپلیکیشن دسکتاپ دریافت کنند، اما هیچیک فعلاً در گفتوگوی عادی ChatGPT ارائه نشدهاند. در API نیز نامهای gpt-6-sol و gpt-6-luna برای آنها استفاده میشود.
اوپنایآی در مقایسههای عملکردی، نسبت هزینه به کارایی را در برابر مدلهای کلاد شرکت آنتروپیک برجسته کرده و در OSWorld 2.0 برای سنجش استفاده از رایانه، OpenAI میگوید GPT-6 Sol نتیجهای مشابه Claude Opus 5 دارد، اما هزینهاش حدود ۸۰ درصد کمتر است؛ با این حال Astra همچنان در این دسته پیشتاز است. در AutomationBench نیز Sol در بالاترین سطح استدلال از Opus 5 عبور میکند.
AutomationBench گردشکارهای کسبوکار را با ۴۷ ابزار بررسی میکند و OpenAI هزینه هر وظیفه با GPT-6 Sol را فقط ۹ درصد هزینه Claude Opus 5 اعلام کرده است. Luna نیز نسبت به مدل قبلی خود ۵.۴ درصد بهبود یافته و ۵۸ درصد هزینه کمتری دارد. در FrontierCode 1.1، توانایی عامل برای ادغام کد در کدبیس موجود، کیفیت تست، سبک کدنویسی و رعایت الزامات سنجیده میشود.
GPT-6 Sol در FrontierCode 1.1 و بالاترین سطح استدلال، امتیاز ۴۹.۳ درصد با هزینه ۲.۱۴ دلار برای هر وظیفه گرفته است؛ نتیجهای نزدیک به Claude Fable 5.1 با امتیاز ۵۰.۳ درصد، اما با هزینه ۱۲.۸۳ دلار. Claude Opus 5 نیز در سطح متوسط استدلال به ۵۳.۴ درصد رسیده و هزینه هر وظیفه آن ۴.۳۱ دلار بوده است؛ این سطح، بهترین نتیجه Opus 5 در آزمون محسوب میشود.
در DeepSWE v1.1 برای سنجش کارهای سنگین مهندسی نرمافزار در کدبیسهای واقعی، GPT-6 Sol در بیشترین سطح استدلال به ۶۸.۸ درصد میرسد. این رقم ۱.۱ درصد کمتر از بهترین نتیجه Claude Fable 5 با ۶۹.۹ درصد در سطح xhigh است؛ Fable 5 در حالت max نیز ۶۹.۷ درصد میگیرد و هزینه هر وظیفه آن ۲۱.۶۳ دلار اعلام شده است.
GPT-6 Sol به دنبال بالاترین امتیاز نیست، Claude Opus 5 در حالت max به ۷۳.۷ درصد با هزینه ۱۱.۸۴ دلار میرسد و GPT-5.6 Sol ۷۲.۷ درصد را با هزینه ۶.۴۶ دلار ثبت کرده است. هدف GPT-6 Sol نزدیک شدن به این نتایج با هزینه کمتر است؛ در xhigh، امتیاز آن ۶۶.۶ درصد با هزینه یک دلار است و Luna این امتیاز را در max با مبلغ ۰.۲۲ دلار به دست میآورد.
اوپنایآی میگوید نتیجه Luna در DeepSWE با عملکرد Claude Opus 5 و Claude Fable 5 در سطح متوسط استدلال قابل مقایسه است و هزینه آن بهترتیب ۹۳ و ۹۶ درصد کمتر است. Luna در max با ۶۶.۶ درصد، نتیجه Sol در xhigh را تکرار میکند و ۷۸ درصد ارزانتر است؛ افزایش Sol به max نیز امتیاز را فقط به ۶۸.۸ درصد میرساند، یعنی ۲.۲ درصد بیشتر.
انتخاب بنچمارکها نیز محل بحث است و در نتایج ارائهشده، معیارهایی مانند GDPval برای کارهای دانشی و Terminal-Bench 4.0 برای کدنویسی عاملمحور دیده نمیشوند، هرچند معمولاً در مجموعه ارزیابیها حضور دارند. همچنین OpenAI ظاهراً همزمان با عرضه Claude Opus 5.5 را پوشش نداده است؛ مدلی که طبق اطلاعات مطرحشده میتواند تا ۴۰ درصد ارزانتر از Opus 5 باشد و عملکرد بهتری ارائه کند.
بررسی مستقل و جایگاه GPT-6 Sol و GPT-6 Luna:
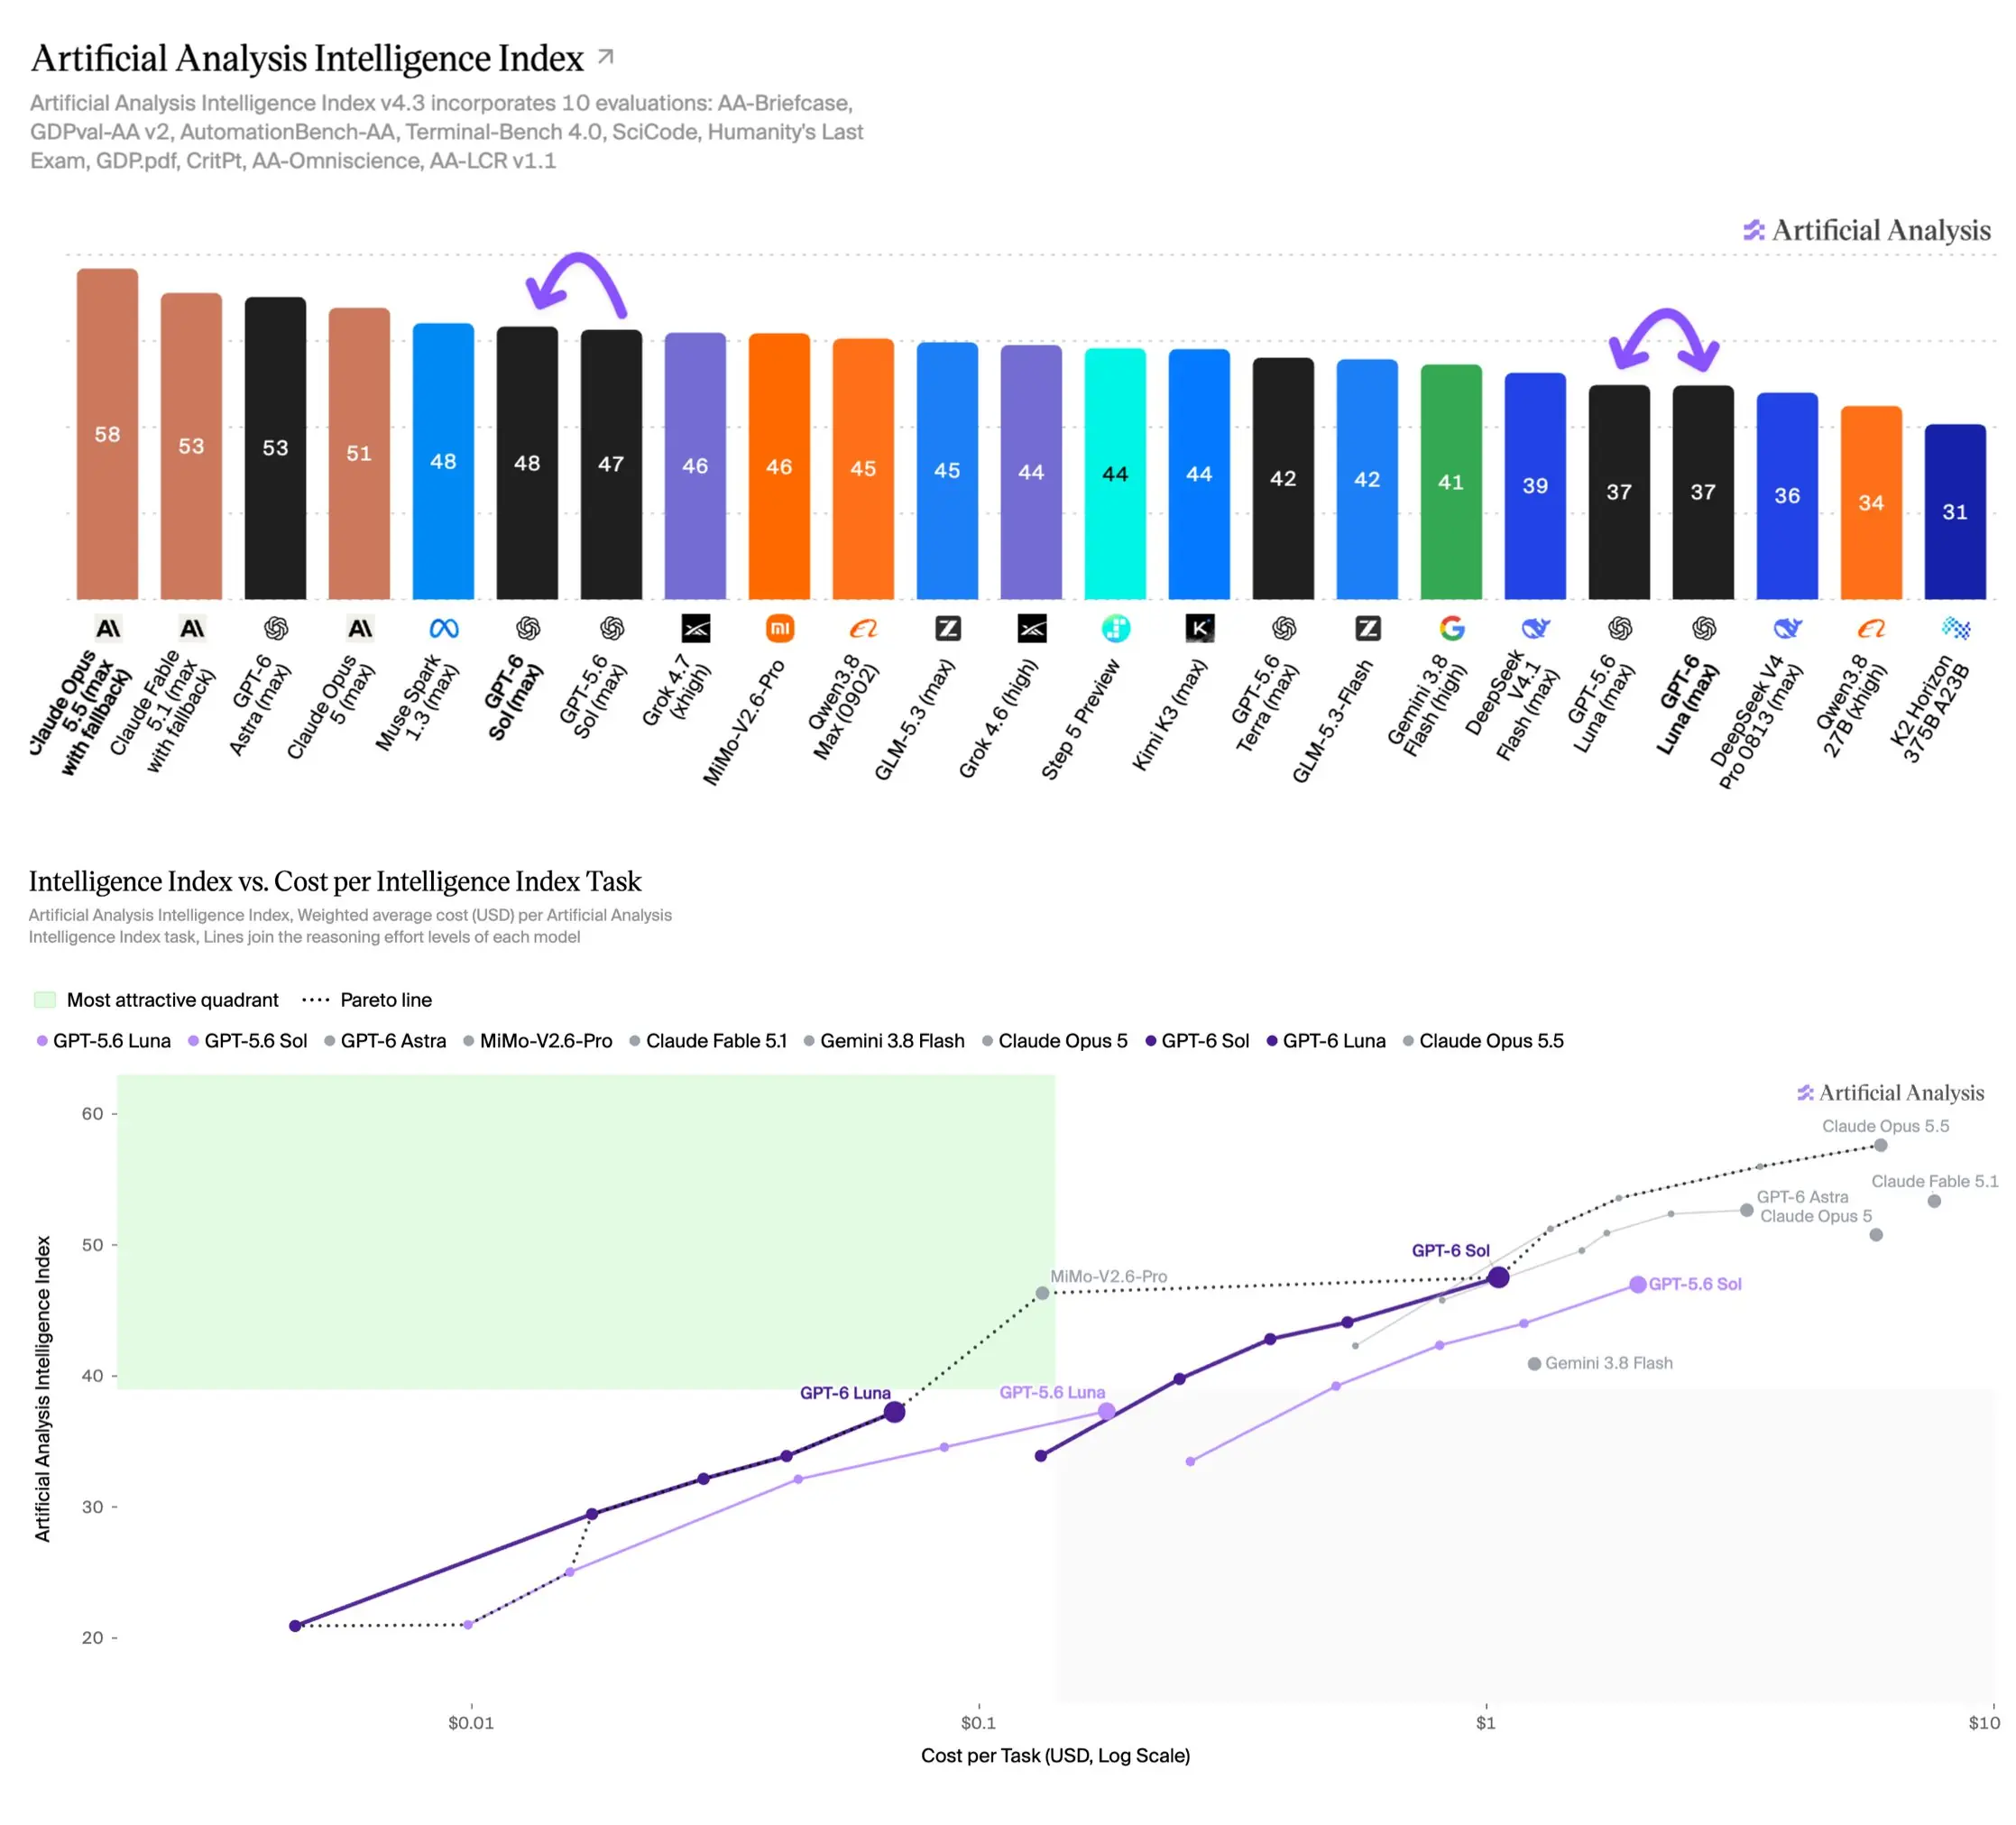
تحلیل مستقل Artificial Analysis تصویر متفاوتی از پیشرفت GPT-6 ارائه میدهد و این ارزیابی نشان میدهد هزینه هر وظیفه در Sol و Luna نسبت به مدلهای قبلی نصف شده، اما امتیاز هوش کلی در سطح GPT-5.6 باقی مانده و در برخی ارزیابیها پیشرفت و در برخی دیگر پسرفت دیده میشود. در شاخص عامل کدنویسی نیز Sol دو امتیاز رشد کرده، در حالی که Luna دو امتیاز افت داشته است.
Artificial Analysis در GDPval-AA v2.1 نیز افت گزارش کرده است؛ آزمونی که کارهای دانشی رایانهای را در ۴۴ حوزه حرفهای بررسی میکند. امتیاز Sol حدود ۱۰۰ واحد Elo و Luna حدود ۷۵ واحد کاهش یافته است. بررسی دستی این افت را عمدتاً به کیفیت پایینتر ارائه و ناقص بودن نتایج نسبت داده است. با این حال، Artificial Analysis پیشتر بهدلیل معیارهای قدیمی در ارزیابی Astra با انتقاد روبهرو شده بود.
پس از آن انتقادها، دو بهروزرسانی در بنچمارکهای GPT-6 Astra انجام شد و این مدل دوباره در جایگاه نخست قرار گرفت؛ بنابراین نتیجهگیری درباره ارزیابیهای GPT-6 نیز به دادههای بعدی وابسته خواهد بود. در مجموع، اطلاعات منتشرشده نشان میدهد OpenAI در Sol و Luna بیش از افزایش چشمگیر توانایی، روی کاهش هزینه تمرکز کرده است. عملکرد این مدلها در کار روزمره مشخص میکند این مزیت قیمتی چقدر کاربردی خواهد بود.